
KI-Modelle brauchen hochwertige Daten, doch traditionelle Methoden können nicht Schritt halten. Die manuelle Datenerfassung ist langsam, teuer und fehleranfällig, während Datenschutzgesetze wie DSGVO und HIPAA zusätzliche Komplexität schaffen. Synthetische Datenpipelines bieten eine Lösung, indem sie künstliche Datensätze generieren, die Muster in echten Daten nachahmen, ohne Datenschutzrisiken. Diese Pipelines sparen Zeit, senken Kosten und verbessern die KI-Leistung. So haben Unternehmen wie ING Belgium und GoDaddy die Datenvorbereitungszeit um bis zu 90 % reduziert und Bußgelder für Datenmissbrauch vermieden. Bis 2028 könnten synthetische Daten 80 % der KI-Trainingsdaten ausmachen und Branchen wie das Gesundheitswesen, das Finanzwesen und autonome Fahrzeuge transformieren.
Wichtige Punkte:
- Datenherausforderungen: Knappheit, Datenschutzvorschriften und hohe Kosten für manuelle Kennzeichnung.
- Vorteile synthetischer Daten: Schnellere Generierung, reduzierte Kosten (bis zu 99 %) und verbesserte Datenschutzkonformität.
- Beispiele aus der Praxis: ING Belgium erstellte 10.000 Zahlungsdatensätze in 2 Minuten und verbesserte die Effizienz von Systemtests.
- Betroffene Branchen: Gesundheitswesen (Forschung zu seltenen Krankheiten), Finanzwesen (Betrugserkennung), Cybersicherheit und autonome Fahrzeuge.
Synthetische Pipelines verändern die KI-Entwicklung und bieten effiziente, skalierbare Lösungen für Datenqualitätsprobleme.
Synthetische Datenpipelines für offene Forschung und skalierbare KI-Entwicklung aufbauen
Wie synthetische Datenpipelines Qualitätsprobleme lösen
Synthetische Datenpipelines sind darauf ausgelegt, künstliche Datensätze zu generieren, die reale Muster nachahmen und gleichzeitig sensible Informationen schützen. Anders als traditionelle Datenerfassungsmethoden folgen diese Pipelines einem strukturierten, mehrstufigen Prozess, der Generierung, Validierung und Verfeinerung umfasst. Fortgeschrittene Techniken wie GANs (Generative Adversarial Networks), VAEs (Variational Autoencoders) und große Sprachmodelle werden häufig eingesetzt, um diese Daten zu erstellen. Anschließend überprüfen strenge Qualitätskontrollen die statistische Genauigkeit und die Einhaltung von Datenschutzstandards, um sicherzustellen, dass die Daten sowohl zuverlässig als auch sicher sind [5][1]. Sehen wir uns an, wie diese Pipelines funktionieren und welche praktischen Vorteile sie bieten.
Was sind synthetische Datenpipelines?
Eine synthetische Datenpipeline ist ein automatisiertes System, das künstliche Datensätze systematisch durch eine kontrollierte Abfolge von Schritten erzeugt. Der Prozess beginnt mit der Datengenerierung, bei der Algorithmen reale Muster analysieren und neue Datensätze erzeugen, die statistische Beziehungen beibehalten. Anschließend folgt die ValidierungPhase misst, wie genau die synthetischen Daten mit dem ursprünglichen Datensatz übereinstimmen. Idealerweise sollten die synthetischen Daten die natürliche Varianz widerspiegeln, die zwischen Trainings- und Holdout-Sets gefunden wird [5].
Die letzte Stufe ist die automatisierte Verfeinerung, die drei wichtige Arten der Filterung umfasst: grundlegende Qualitätsprüfungen, Sicherstellung der Label-Konsistenz und Ausrichtung der Datenverteilung. Dieser strukturierte Ansatz behebt direkt häufige Datenqualitätsprobleme. Beispielsweise hat MOSTLY AI dieses Framework im Jahr 2023 auf den UCI Adult Income Datensatz (39.074 Datensätze) angewendet. Durch die Aufteilung der Daten in Trainings- und Holdout-Sets und die Messung der Total Variational Distance erzielten sie eine durchschnittliche Gesamtgenauigkeit von 98,3 % – mit 98,9 % univariater Genauigkeit und 97,7 % bivariater Genauigkeit für den synthetischen Datensatz [5]. Dieser robuste Prozess garantiert nicht nur statistische Präzision, sondern liefert auch praktische, messbare Ergebnisse.
Vorteile der Verwendung synthetischer Daten
Synthetische Datenpipelines bieten klare Lösungen für häufige Datenqualitätsprobleme und liefern Vorteile, die sowohl bedeutend als auch messbar sind. Ein Hauptvorteil ist ihre Fähigkeit, Randfallknappheit zu adressieren. Im Gegensatz zur manuellen Kennzeichnung, die teuer und zeitaufwendig sein kann [1], reduziert die synthetische Erzeugung die Kosten erheblich. Beispielsweise nutzte ING Belgien im Januar 2026 die Synthetic Data Vault (SDV), um in nur 2 Minuten 10.000 synthetische Zahlungsdatensätze zu erstellen. Dieser Ansatz erhöhte die Testabdeckung für ihr SEPA-Zahlungsverarbeitungssystem um das 100-Fache, während nur ein Bruchteil des zuvor benötigten manuellen Aufwands erforderlich war [1].
Ein weiterer wichtiger Vorteil ist die verbesserte Einhaltung des Datenschutzes durch die Verwendung von Differential Privacy (DP). Im Gegensatz zu herkömmlichen Anonymisierungstechniken bieten DP-fähige Pipelines mathematische Garantien für die De-Identifizierung von Daten und entsprechen den "Privacy by Design"-Prinzipien der DSGVO [1]. Unternehmenslösungen können bis zu 97,8 % Genauigkeit bei der Bewahrung statistischer Beziehungen erreichen, während sie Datenschutzmaßnahmen aufrechterhalten [1]. Dies ist besonders wichtig angesichts der finanziellen Risiken bei Nichteinhaltung – DSGVO-Bußgelder können 20 Millionen Euro übersteigen, und HIPAA-Verstöße kosten durchschnittlich 10,4 Millionen Euro pro Vorfall [1].
Schließlich beschleunigen synthetische Datenpipelines die Entwicklung und senken die Kosten erheblich. Organisationen, die synthetische Daten nutzen, berichten von Kostensenkungen von bis zu 99 % und einer zehnfachen Steigerung der Geschwindigkeit bei der Modellbereitstellung [1]. Bis 2026 werden synthetische Daten voraussichtlich 60 % aller KI-Trainingsdaten ausmachen [1]. Diese Kombination aus Geschwindigkeit, Bezahlbarkeit und regulatorischer Konformität macht synthetische Pipelines zu einem unverzichtbaren Bestandteil der modernen KI-Entwicklung.
Aufbau einer synthetischen Datenpipeline
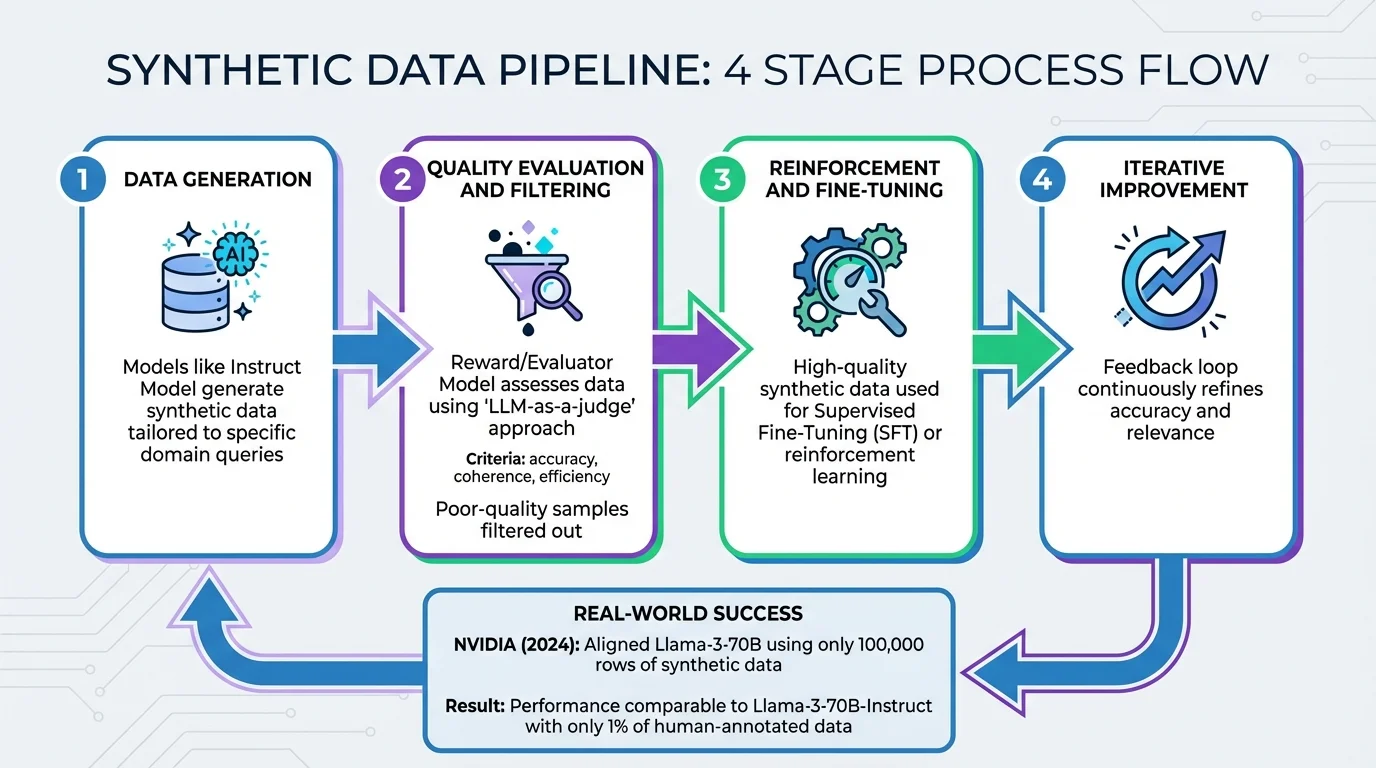
Mit dem Aufbau einer synthetischen Datenpipeline können Sie die Vorteile synthetischer Daten in praktische Arbeitsabläufe umsetzen. Dieser Prozess umfasst eine Reihe miteinander verbundener Phasen, die jeweils eine entscheidende Rolle für den Erfolg der Pipeline spielen. Betrachten wir diese Phasen und die Technologien, die Ihnen beim Aufbau eines zuverlässigen Systems helfen können.
Hauptphasen einer synthetischen Datenpipeline
Eine gut strukturierte Pipeline umfasst in der Regel vier Schlüsselphasen:
- Datengenerierung: Hier werden synthetische Daten erzeugt. Modelle wie ein Instruct Model werden verwendet, um Daten zu generieren, die auf spezifische Domänenabfragen zugeschnitten sind [7].
- Qualitätsbewertung und Filterung: In dieser Phase bewertet ein Reward- oder Evaluator-Modell die synthetischen Daten anhand von Kriterien wie Genauigkeit, Kohärenz und Effizienz [6][7]. Dieser Ansatz, oft als „LLM-as-a-judge“ bezeichnet, automatisiert die Bewertung und Rangfolge synthetischer Stichproben und macht kostspielige menschliche Annotation überflüssig. Stichproben minderer Qualität werden herausgefiltert [6][7].
- Verstärkung und Feinabstimmung: Hochwertige synthetische Daten aus der vorherigen Phase werden für Supervised Fine-Tuning (SFT) oder Reinforcement-Learning-Techniken verwendet, um das Modell weiter zu verbessern.
- Iterative Verbesserung: Dieser Schritt führt eine Rückkopplungsschleife ein, um die Genauigkeit und Relevanz der synthetischen Daten kontinuierlich zu verfeinern [6].
Ein bemerkenswertes Beispiel für diesen Prozess in der Praxis stammt von NVIDIA aus dem Jahr 2024. Sie richteten ihr Llama-3-70B-Basismodell mit nur 100.000 Zeilen synthetischer Konversationsdaten (bekannt als „Daring Anteater“-Datensatz) aus. Dieser Ansatz erzielte eine Leistung, die mit Llama-3-70B-Instruct vergleichbar war, und stützte sich dabei auf nur 1 % der von Menschen annotierten Daten [7]. Dies zeigt, wie eine gut gestaltete Pipeline den Bedarf an manueller Kennzeichnung erheblich reduzieren kann, ohne die Leistung zu beeinträchtigen.
Tools und Technologien, die Sie nutzen können
Der Erfolg jeder Phase hängt stark von der Wahl der richtigen Tools ab. Hier ein Blick auf einige verfügbare Optionen:
- Generierungstechnologien:
- Generative Adversarial Networks (GANs) sind ideal für die Erstellung hochwertiger Bilder.
- Variational Autoencoder (VAEs) sind effektiv für eine stabile Anomalieerkennung.
- Große Sprachmodelle wie Claude 3.7, Llama 3 und GPT-o3 zeichnen sich bei der Text- und Codegenerierung aus.
- Diffusionsmodelle gewinnen an Bedeutung für die Erstellung hochwertiger visueller Inhalte und die Verfeinerung strukturierter Daten [4][11].
- Pipeline-Orchestrierung und -Verwaltung:
- Apache Airflow und Dagster ermöglichen die automatisierte Planung und Überwachung von Workflows [10].
- Databricks Unity Catalog bietet eine zentrale Governance für synthetische Daten und KI-Modelle.
- DreamFactory vereinfacht die Erstellung sicherer REST-APIs, um synthetische Datenquellen ohne manuelle Codierung mit Trainingsumgebungen zu verbinden [4][9].
- CI/CD-Tools automatisieren die Bereitstellung von Datensätzen zu Testzwecken [8].
Bei den Tools können Sie je nach Bedarf zwischen Open-Source- und kommerziellen Optionen wählen:
- Open-Source-Tools wie SDV (Synthetic Data Vault), Apache Airflow und Faker sind kostenlos und hervorragend für Forschung oder Prototyping geeignet [10][1].
- Für Anforderungen auf Unternehmensebene bieten Lösungen wie Gretel Synthetics verwaltete Plattformen mit Preisen von 280 € bis über 9.500 € pro Monat. NVIDIAs Nemotron-4 340B, verfügbar unter einer permissiven Lizenz, ist eine weitere starke Option für die kommerzielle Nutzung [1][6].
Die meisten erfolgreichen Implementierungen verwenden eine „Core-Expansion“-Strategie, die 70–80 % hochwertige, von Menschen erzeugte Daten mit 20–30 % synthetischen Daten kombiniert. Dieser Ansatz gewährleistet eine präzise Datenverteilung und deckt gleichzeitig Randfälle ab [1].
„Hochwertige Trainingsdaten spielen eine entscheidende Rolle für die Leistung, Genauigkeit und Qualität der Antworten eines benutzerdefinierten LLM – aber robuste Datensätze können unerschwinglich teuer und schwer zugänglich sein.“ – NVIDIA [6]
Branchenanwendungen und Fallstudien
Synthetische Daten im Gesundheitswesen, im Finanzwesen, in der Cybersicherheit und bei autonomen Fahrzeugen
Pipelines für synthetische Daten sorgen branchenübergreifend für Aufsehen, indem sie kritische Herausforderungen wie Datenknappheit, Datenschutzbedenken und Ungleichgewichte in Datensätzen angehen. Schauen wir uns genauer an, wie sie eingesetzt werden:
Im Gesundheitswesen helfen synthetische Daten, den Mangel an Informationen über seltene Krankheiten zu bewältigen und gleichzeitig die Privatsphäre der Patienten zu schützen. Beispielsweise nutzten Forscher in Neuseeland synthetische Umfragedaten, um vorherzusagen, dass Arztbesuche von Personen ab 65 Jahren in Szenarien mit hoher Morbidität jährlich von 8,8 auf 15,3 steigen könnten. Diese Erkenntnis trägt zu einer besseren Ressourcenallokation bei [14]. Darüber hinaus können synthetische Daten Verzerrungen reduzieren, indem unterrepräsentierte Gruppen überabgetastet werden [13][14].
Im Finanzsektor spielen synthetische Daten eine Schlüsselrolle bei Risikomanagement, Portfoliooptimierung und algorithmischem Handel – und erfüllen dabei strenge Datenschutzstandards. Durch das Upsampling von Minderheitsklassen in unausgewogenen Transaktionsdatensätzen verstärken Finanzinstitute das „Betrugssignal“ in Erkennungssystemen. Dieser Ansatz ist besonders nützlich, um die Seltenheit von Immobilienbetrugsfällen zu adressieren, bei denen oft nicht genügend Daten zur Verfügung stehen, um effektive KI-Modelle zu trainieren [17][18].
Cybersicherheit profitiert von synthetischen Daten, indem Datensätze für Systeme zur Erkennung von Eindringversuchen ausgeglichen und adversariale Eingaben generiert werden, um die Modellsicherheit zu testen. Dieses automatisierte "Red-Teaming" gewährleistet robuste Sicherheitsmaßnahmen [13][15]. In der Entwicklung autonomer Fahrzeuge reduzieren synthetische Datenpipelines den Bedarf an gekennzeichneten Daten um 90 %, während sie die Leistung von Wahrnehmungsmodellen unter herausfordernden Bedingungen wie extremem Wetter oder schlechten Lichtverhältnissen verbessern [16].
Leistungsvergleich: Basislinien- vs. synthetische Datenmodelle
Die Wirkung synthetischer Daten zeigt sich in ihrer Fähigkeit, die Leistung von KI-Modellen zu steigern. Beispielsweise erreichten Jianhao Yuan und Kollegen im März 2024 eine Top-1-Klassifikationsgenauigkeit von 70,9 % auf ImageNet1K unter ausschließlicher Verwendung synthetischer Daten. Die zehnfache Skalierung der synthetischen Pipeline erhöhte die Genauigkeit auf 76,0 % [2]. Ebenso übertrafen Modelle, die mit synthetischen CT-Scans des Brustkorbs für die COVID-19-Erkennung trainiert wurden, solche, die mit begrenzten realen Datensätzen trainiert wurden [14].
Hier ist eine Aufschlüsselung, wie synthetische Daten spezifische Herausforderungen in verschiedenen Branchen lösen:
Branche | Primärer Anwendungsfall | Gelöste Datenqualitätsherausforderung |
|---|---|---|
Gesundheitswesen | Training von Diagnosemodellen (z. B. COVID-19) | Datenknappheit und Patientenschutz [14] |
Finanzen | Betrugserkennung & Risikobewertung | Regulatorische Konformität und verschiedene Datentypen [12] |
Cybersicherheit | Erkennung von Eindringversuchen & Red-Teaming | |
Autonome Fahrzeuge | Training von Wahrnehmungsmodellen | Extreme Bedingungen und reduzierter Bedarf an gelabelten Daten[16] |
Marginalbasierte synthetische Datengeneratoren wie AIM und MWEM PGM verbessern maschinelles Lernen weiter, indem sie Ergebnisse liefern, die nahezu identisch mit denen sind, die auf realen Daten trainiert wurden[19]. Wenn man bedenkt, dass bis zu 80 % der Entwicklungszeit für KI mit der Aufbereitung realer Daten verbracht wird[3], revolutionieren synthetische Datenpipelines die Art und Weise, wie Organisationen das Modelltraining angehen. Durch die Bewältigung von Datenqualitätsbeschränkungen sparen sie nicht nur Zeit, sondern treiben auch erhebliche Verbesserungen der KI-Effektivität voran.
So implementieren Sie synthetische Datenpipelines
Schritte zur Einführung synthetischer Daten
Beginnen Sie damit, das spezifische Problem zu identifizieren, das Sie lösen möchten. Handelt es sich um Randfälle, Datenschutzbedenken oder Datenungleichgewichte? Eine klare Definition hilft Ihnen, den erforderlichen Umfang und Detaillierungsgrad zu bestimmen, insbesondere da die manuelle Kennzeichnung von Daten teuer und zeitaufwendig sein kann.
Beginnen Sie mit einem Proof of Concept (PoC) mit 1.000 bis 10.000 nicht sensiblen Datensätzen. Open-Source-Tools wie SDV eignen sich hervorragend zum Testen der Qualität synthetischer Daten, bevor Sie skalieren[1]. Indem Sie das Schema Ihrer realen Daten spiegeln – während Sie eindeutige Identifikatoren ausschließen – können Sie Überanpassung vermeiden und Datenschutzrisiken reduzieren[20][21]. Die Generierung synthetischer Daten kann im Vergleich zu manuellen Methoden erhebliche Zeit und Mühe sparen.
Bei der Auswahl von Methoden sind Gaussian Copulas hervorragend für schnelle Basislinien, während GANs und VAEs besser geeignet sind, um komplexe Beziehungen in tabellarischen, Text- oder Bilddaten zu erfassen. Validieren Sie Ihre synthetischen Daten, indem Sie statistische Tests gegen Holdout-Sets durchführen[5]. Teilen Sie Ihre Daten immer in Trainings- und Holdout-Sets auf, um Auswendiglernen zu verhindern [5]. Dieser Prozess kann dann direkt in eine automatisierte Rückkopplungsschleife einfließen.
Automatisieren Sie Rückkopplungsschleifen mithilfe von Tools wie Python-Skripten oder Airflow, um die Qualität der synthetischen Daten zu bewerten. Stichproben, die die Qualitätsstandards nicht erfüllen, können automatisch verworfen werden [20]. Beispielsweise übernahm im Februar 2026 Paytient das synthetische Datensystem von Tonic.ai für die Verarbeitung sensibler Gesundheits- und Zahlungsdaten, was ihre Effizienz erheblich verbesserte [24]. Ähnlich Flywire ersetzte manuelle Skripte durch automatisierte synthetische Datengenerierung, wodurch die Zeit für die Einrichtung neuer Testumgebungen von 20 Tagen auf nur wenige Minuten reduziert wurde [24].
Beim Übergang zur Produktion sollten Sie einem "Kriechen, Gehen, Laufen"-Ansatz folgen. Beginnen Sie klein mit überschaubaren Datensätzen und kurzen Trainingszyklen (1 bis 10 Minuten). Skalieren Sie schrittweise auf komplexere Umgebungen mit mehreren Tabellen hoch [22]. Ein hybrider Ansatz funktioniert oft am besten – kombinieren Sie 70–80 % hochwertige reale Daten mit 20–30 % synthetischen Daten. Dies gewährleistet Realismus und deckt gleichzeitig Randfälle ab [1]. Beginnen Sie das groß angelegte Training mit synthetischen Daten und verwenden Sie für die finale Feinabstimmung reale Daten, um Ihr Modell in der Realität zu verankern [23].
Best Practices für die Aufrechterhaltung der Qualität
Sobald Ihre Pipeline läuft, ist die Aufrechterhaltung der Datenqualität entscheidend. Bewerten Sie Ihre synthetischen Daten anhand von drei Schlüsseldimensionen: Fidelity (wie genau sie reale Daten widerspiegeln), Nützlichkeit (ihre Wirksamkeit in nachgelagerten maschinellen Lernaufgaben) und Datenschutz (sicherzustellen, dass er vor Re-Identifizierung schützt). Für die Produktion sollten Datenschutz ≥85 %, Nutzen ≥80 % und Wiedergabetreue ≥90 % angestrebt werden. Darüber hinaus sollte die univariate Übereinstimmung über 85 % liegen, bivariate Trends über 80 % und das Singling-out-Risiko unter 1 % bleiben [1].
Pflegen Sie einen "Goldstandard" – einen kuratierten, hochwertigen Datensatz, der als Benchmark für die Generierung synthetischer Daten dient [1]. Vermeiden Sie es, Ihre Modelle zu stark auf den gesamten Datensatz abzustimmen. Führen Sie stattdessen Zufälligkeit und Rauschen ein, um Randfälle zu erfassen, ohne einfach häufige Muster zu replizieren [21]. Integrieren Sie differenzielle Privatsphäre (DP) während des Trainings, um die Compliance-Standards von GDPR und HIPAA zu erfüllen und gleichzeitig mathematische Garantien für die De-Identifizierung zu bieten [1].
"Synthetische Daten sind nicht nur eine Alternative, sondern ein Kernbestandteil für skalierbare KI-Entwicklung." – Nascenia [20]
Wenn sich Ihre Produktionsdaten weiterentwickeln, versionieren Sie Ihre Generatoren und überwachen Sie auf Drift. Nutzen Sie MLOps-Plattformen wie Kubeflow oder Airflow, um den Prozess der Auswahl des besten Synthesizers zu automatisieren, indem Sie parallele Bewertungen verschiedener Modelle durchführen [1]. Taggen Sie Metadaten, stellen Sie Kompatibilität sicher und speichern Sie validierte Daten in Formaten wie CSV oder JSON, um sie nahtlos in Ihre bestehenden Machine-Learning-Pipelines zu integrieren.
Fazit: Lösung von AIs Datenqualitätsproblem mit synthetischen Pipelines
Synthetische Datenpipelines sind zu einem Eckpfeiler für die Weiterentwicklung der KI geworden. Bis 2028 werden schätzungsweise 80 % der KI-Trainingsdaten synthetisch sein, ein dramatischer Anstieg von nur 5 % im Jahr 2021 [25]. Dieser Wandel geht einige der größten Hürden der KI an: begrenzte Datenverfügbarkeit, Datenschutzbedenken, Verzerrungen und die Schwierigkeit, seltene Randfälle sicher zu behandeln. Das Ergebnis? Erhebliche operative und kostensparende Vorteile.
Organisationen, die synthetische Pipelines einführen, können Kosten um bis zu 99 % senken und die Modellbereitstellung um den Faktor 10 beschleunigen [1]. Beispielsweise kann die manuelle Kennzeichnung eines einzelnen Randfalls 47.000 € kosten, während die Generierung synthetischer Daten dies auf nur 470 € reduziert [1]. Ein reales Beispiel stammt von GoDaddy, das im Januar 2026 berichtete, den Zeitaufwand für die Erstellung von Testdaten um 90 % reduziert und die Notwendigkeit von Produktionsdaten in Testumgebungen vollständig eliminiert zu haben [26].
Synthetische Daten mildern nicht nur die Knappheit, sondern übertreffen häufig echte Daten.
- Kalyan Veeramachaneni, Principal Research Scientist, MIT [25]
Diese Vorteile sind in verschiedenen Branchen spürbar. Im Gesundheitswesen ermöglichen synthetische Pipelines die Erforschung seltener Krankheiten und wahren gleichzeitig die Einhaltung von Vorschriften wie HIPAA. Im Finanzwesen können Institutionen Betrugserkennungssysteme mit Millionen synthetischer Transaktionen testen. Unternehmen für autonome Fahrzeuge können unterdessen Milliarden von Kilometern Fahrbetrieb unter Bedingungen simulieren, die in der realen Welt unmöglich nachzubilden wären [25].
FAQs
Wie schützen synthetische Datenpipelines die Privatsphäre und bleiben gleichzeitig konform mit Vorschriften?
Synthetische Datenpipelines spielen eine entscheidende Rolle bei der Einhaltung des Datenschutzes, indem sie fortschrittliche Techniken zur Anonymisierung von Daten und zum Schutz sensibler Informationen einsetzen. Diese Pipelines erzeugen synthetische Daten, die losgelöst vom ursprünglichen Datensatz sind, was dazu beiträgt, die Wahrscheinlichkeit einer Re-Identifizierung oder von Datenschutzverletzungen zu minimieren.
Eine besonders hervorstechende Methode ist differentielle Privatsphäre, ein mathematisches Framework, das begrenzt, wie viele Informationen synthetische Daten über den ursprünglichen Datensatz preisgeben können. Andere Techniken wie Datenschutzmaskierung und sorgfältig gestaltete Syntheseregeln stellen sicher, dass die erzeugten Daten von echten Daten unterscheidbar bleiben. Diese Maßnahmen sind darauf ausgelegt, Datenschutzgesetze wie DSGVO und HIPAA einzuhalten, sodass Organisationen hochwertige Daten für KI-Training nutzen können, ohne rechtliche und ethische Grenzen zu überschreiten.
Welche Branchen profitieren am meisten von synthetischen Datenpipelines?
Synthetische Datenpipelines verändern Branchen, die mit Problemen wie begrenzter Datenverfügbarkeit, Datenschutzbeschränkungen oder dem Bedarf an vielfältigen Datensätzen zu kämpfen haben. Nehmen wir zum Beispiel das Gesundheitswesen und die biomedizinische Forschung. Diese Bereiche setzen auf synthetische Daten, um die Privatsphäre von Patienten zu schützen und gleichzeitig das Training von KI-Modellen und Forschungsbemühungen voranzutreiben.
In der Fertigung spielen synthetische Daten eine andere, aber ebenso wichtige Rolle. Sie helfen, Abläufe zu optimieren, Analysefähigkeiten zu stärken und Kosten im Zusammenhang mit der Erfassung und Kennzeichnung von Daten zu senken.
Darüber hinaus profitieren Sektoren wie das Finanzwesen, die Telekommunikation und öffentliche DiensteAuch auf synthetische Daten zurückgreifen. Sie ermöglichen einen sicheren Datenaustausch, tragen zur Reduzierung von Verzerrungen bei und stellen die Einhaltung von Datenschutzgesetzen sicher. Diese Pipelines sind ein Paradigmenwechsel, der es Organisationen ermöglicht, die KI-Entwicklung zu beschleunigen, die Modellpräzision zu verbessern und wertvolle Erkenntnisse aus sensiblen oder knappen Datensätzen zu gewinnen – und dabei strenge Datenschutzanforderungen zu erfüllen.
Wie verbessern synthetische Datenpipelines die Leistung von KI-Modellen?
Synthetische Datenpipelines spielen eine Schlüsselrolle bei der Steigerung der KI-Modellleistung, indem sie Probleme wie begrenzte Datenverfügbarkeit und Verzerrungen angehen. Diese Pipelines erstellen gut entwickelte, repräsentative Datensätze, die dazu beitragen, Modellpräzision, Konsistenz und Anpassungsfähigkeit zu verbessern.
Durch die Nachbildung einer Vielzahl von Szenarien ermöglichen diese Systeme schnellere Trainings- und Testprozesse und reduzieren die Abhängigkeit von teuren oder schwer zugänglichen realen Daten. Dieser Ansatz stellt sicher, dass KI-Modelle besser darauf vorbereitet sind, mit realen Komplexitäten umzugehen, was zu zuverlässigeren Vorhersagen und Ergebnissen führt.
Verwandte Blogbeiträge
- Jenseits des Hype-Zyklus: Warum die C-Suite 'Intimität im Maßstab' über Mega-Messen priorisiert.
- Der Chief AI Officer-Leitfaden: 5 Prioritäten für die nächsten 12 Monate.
- Die Energie-Compute-Verbindung: Kann KI bis 2030 nachhaltig sein?
- Vom Samen zur Skalierung: Lehren aus den neuesten Einhörnern Europas.