
Les modèles d'IA ont besoin de données de qualité, mais les méthodes traditionnelles ne suivent pas. La collecte manuelle de données est lente, coûteuse et sujette aux erreurs, tandis que les lois sur la confidentialité comme le RGPD et HIPAA ajoutent de la complexité. Les pipelines de données synthétiques offrent une solution en générant des jeux de données artificiels qui imitent les schémas des données réelles sans risques pour la vie privée. Ces pipelines permettent d'économiser du temps, de réduire les coûts et d'améliorer les performances de l'IA. Par exemple, des entreprises comme ING Belgique et GoDaddy ont réduit le temps de préparation des données jusqu'à 90 % et évité des amendes pour utilisation abusive des données. D'ici 2028, les données synthétiques pourraient représenter 80 % des données d'entraînement de l'IA, transformant des secteurs comme la santé, la finance et les véhicules autonomes.
Points clés :
- Défis liés aux données : Pénurie, réglementations sur la confidentialité et coûts élevés d'étiquetage manuel.
- Avantages des données synthétiques : Génération plus rapide, coûts réduits (jusqu'à 99 %) et meilleure conformité en matière de confidentialité.
- Exemples concrets : ING Belgique a créé 10 000 enregistrements de paiement en 2 minutes, améliorant l'efficacité des tests système.
- Secteurs impactés : Santé (recherche sur les maladies rares), finance (détection de fraude), cybersécurité et véhicules autonomes.
Les pipelines synthétiques transforment le développement de l'IA en offrant des solutions évolutives et efficaces aux problèmes de qualité des données.
Construire des pipelines de données synthétiques pour la recherche ouverte et le développement évolutif de l'IA
Comment les pipelines de données synthétiques résolvent les problèmes de qualité
Les pipelines de données synthétiques sont conçus pour générer des jeux de données artificiels qui imitent les schémas du monde réel tout en garantissant la protection des informations sensibles. Contrairement aux méthodes traditionnelles de collecte de données, ces pipelines suivent un processus structuré en plusieurs étapes comprenant la génération, la validation et le raffinement. Des techniques avancées comme les GAN (réseaux antagonistes génératifs), les VAE (autoencodeurs variationnels) et les grands modèles de langage sont souvent utilisées pour créer ces données. Des contrôles de qualité rigoureux vérifient ensuite l'exactitude statistique et la conformité aux normes de confidentialité, garantissant que les données sont à la fois fiables et sécurisées [5][1]. Décomposons le fonctionnement de ces pipelines et les avantages pratiques qu'ils apportent.
Que sont les pipelines de données synthétiques ?
Un pipeline de données synthétiques est un système automatisé qui produit systématiquement des jeux de données artificiels via une série contrôlée d'étapes. Le processus commence par la génération de données, où les algorithmes analysent les schémas du monde réel et génèrent de nouveaux enregistrements qui maintiennent les relations statistiques. Ensuite, le validation mesure la mesure dans laquelle les données synthétiques correspondent au jeu de données original. Idéalement, les données synthétiques devraient refléter la variance naturelle observée entre les ensembles d'entraînement et de validation [5].
La dernière étape est l'affinage automatisé, qui comprend trois types clés de filtrage : les contrôles de qualité de base, la garantie de la cohérence des étiquettes et l'alignement de la distribution des données. Cette approche structurée répond directement aux problèmes courants de qualité des données. Par exemple, en 2023, MOSTLY AI a appliqué ce cadre au jeu de données UCI Adult Income (39 074 enregistrements). En divisant les données en ensembles d'entraînement et de validation et en mesurant la distance variationnelle totale, ils ont atteint une précision globale moyenne de 98,3 % - avec une précision univariée de 98,9 % et une précision bivariée de 97,7 % pour le jeu de données synthétiques [5]. Ce processus robuste garantit non seulement une précision statistique, mais fournit également des résultats pratiques et mesurables.
Avantages de l'utilisation des données synthétiques
Les pipelines de données synthétiques offrent des solutions claires aux défis courants de qualité des données, apportant des avantages à la fois significatifs et mesurables. Un avantage majeur est leur capacité à remédier à la rareté des cas limites. Contrairement à l'étiquetage manuel, qui peut être coûteux et chronophage [1], la génération synthétique réduit considérablement les coûts. Par exemple, en janvier 2026, ING Belgique a utilisé le Synthetic Data Vault (SDV) pour créer 10 000 enregistrements de paiement synthétiques en seulement 2 minutes. Cette approche a multiplié par 100 la couverture des tests de leur système de traitement des paiements SEPA, tout en ne nécessitant qu'une fraction de l'effort manuel auparavant nécessaire [1].
Un autre avantage clé est l'amélioration de la conformité en matière de vie privée grâce à l'utilisation de la confidentialité différentielle (DP). Contrairement aux techniques d'anonymisation traditionnelles, les pipelines compatibles DP fournissent des garanties mathématiques de dé-identification des données, en phase avec les principes « Privacy by Design » du RGPD [1]. Les solutions de niveau entreprise peuvent atteindre une précision allant jusqu'à 97,8 % dans la préservation des relations statistiques tout en maintenant les protections de la vie privée [1]. Cela est particulièrement crucial compte tenu des risques financiers de non-conformité - les amendes RGPD peuvent dépasser 20 millions d'euros, et les violations HIPAA atteignent désormais en moyenne 10,4 millions d'euros par incident [1].
Enfin, les pipelines de données synthétiques accélèrent le développement et réduisent considérablement les coûts. Les organisations qui utilisent des données synthétiques signalent des réductions de coûts allant jusqu'à 99 % et une augmentation décuplée de la vitesse de déploiement des modèles [1]. D'ici 2026, les données synthétiques devraient représenter 60 % de toutes les données d'entraînement de l'IA [1]. Cette combinaison de vitesse, d'abordabilité et d'alignement réglementaire fait des pipelines synthétiques un élément essentiel du développement moderne de l'IA.
Construction d'un pipeline de données synthétiques
La création d'un pipeline de données synthétiques vous permet de transformer les avantages des données synthétiques en flux de travail pratiques. Ce processus implique une série d'étapes interconnectées, chacune jouant un rôle critique pour garantir le succès du pipeline. Décomposons ces étapes et les technologies qui peuvent vous aider à construire un système fiable.
Principales étapes d'un pipeline de données synthétiques
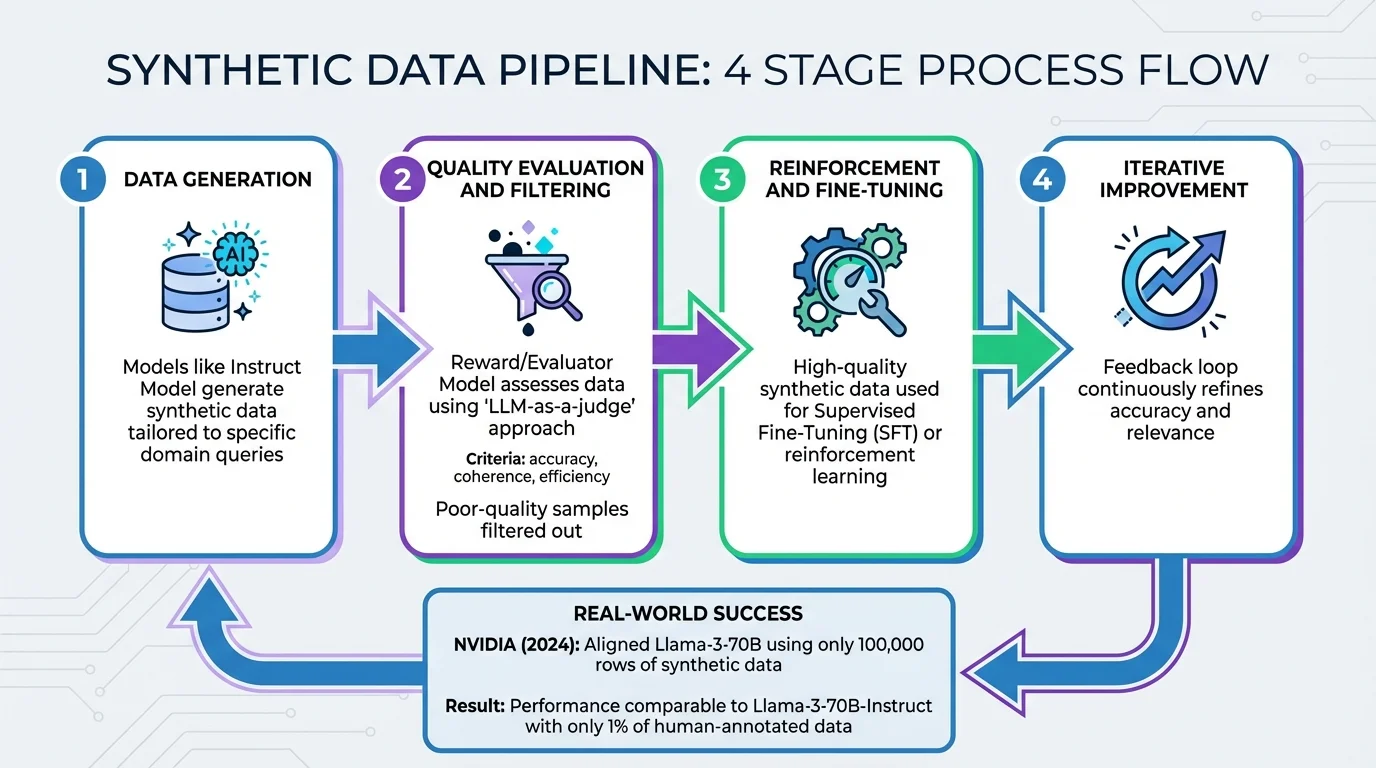
Un pipeline bien structuré comprend généralement quatre étapes clés :
- Génération de données: C'est là que les données synthétiques sont créées. Des modèles comme un modèle d'instruction sont utilisés pour générer des données adaptées à des requêtes spécifiques du domaine [7].
- Évaluation et filtrage de la qualité: À cette étape, un modèle de récompense ou d'évaluation évalue les données synthétiques en fonction de critères tels que l'exactitude, la cohérence et l'efficacité [6][7]. Cette approche, souvent appelée « LLM-as-a-judge », automatise la notation et le classement des échantillons synthétiques, éliminant le besoin d'annotation humaine coûteuse. Les échantillons de mauvaise qualité sont filtrés [6][7].
- Renforcement et ajustement fin: Les données synthétiques de haute qualité de l'étape précédente sont utilisées pour l'ajustement fin supervisé (SFT) ou des techniques d'apprentissage par renforcement afin d'améliorer davantage le modèle.
- Amélioration itérative: Cette étape introduit une boucle de rétroaction pour affiner en continu l'exactitude et la pertinence des données synthétiques [6].
Un exemple remarquable de ce processus en action vient de NVIDIA en 2024. Ils ont aligné leur modèle de base Llama-3-70B en utilisant seulement 100 000 lignes de données conversationnelles synthétiques (surnommées le jeu de données « Daring Anteater »). Cette approche a atteint des performances comparables à Llama-3-70B-Instruct tout en ne s'appuyant que sur 1 % des données annotées par des humains [7]. Cela montre comment un pipeline bien conçu peut réduire considérablement le besoin d'étiquetage manuel sans sacrifier les performances.
Outils et technologies que vous pouvez utiliser
Le succès de chaque étape dépend fortement du choix des bons outils. Voici un aperçu des options disponibles :
- Technologies de génération :
- Les réseaux antagonistes génératifs (GAN) sont idéaux pour créer des images de haute qualité.
- Les autoencodeurs variationnels (VAE) sont efficaces pour la détection stable d'anomalies.
- Les grands modèles de langage comme Claude 3.7, Llama 3 et GPT-o3 excellent dans la génération de texte et de code.
- Les modèles de diffusion gagnent en popularité pour produire des visuels de haute qualité et affiner les données structurées [4][11].
- Orchestration et gestion des pipelines :
- Apache Airflow et Dagster permettent la planification automatisée et la surveillance des flux de travail [10].
- Databricks Unity Catalog offre une gouvernance centralisée pour les données synthétiques et les modèles d'IA.
- DreamFactory simplifie la création d'API REST sécurisées pour connecter les sources de données synthétiques aux environnements d'entraînement sans codage manuel [4][9].
- Les outils CI/CD automatisent la fourniture de jeux de données à des fins de test [8].
En ce qui concerne les outils, vous pouvez choisir entre des options open-source et commerciales en fonction de vos besoins :
- Les outils open-source comme SDV (Synthetic Data Vault), Apache Airflow et Faker sont gratuits et excellents pour la recherche ou le prototypage [10][1].
- Pour les exigences de niveau entreprise, des solutions comme Gretel Synthetics proposent des plateformes gérées avec des prix allant de 280 € à plus de 9 500 € par mois. Le Nemotron-4 340B de NVIDIA, disponible sous une licence permissive, est une autre option solide pour un usage commercial [1][6].
La plupart des implémentations réussies utilisent une stratégie "Core-Expansion", mélangeant 70 à 80 % de données humaines de haute qualité avec 20 à 30 % de données synthétiques. Cette approche garantit une distribution précise des données tout en couvrant les cas limites [1].
"Des données d'entraînement de haute qualité jouent un rôle critique dans la performance, la précision et la qualité des réponses d'un LLM personnalisé - mais des ensembles de données robustes peuvent être prohibitifs en coût et difficiles à obtenir." - NVIDIA [6]
Applications industrielles et études de cas
Données synthétiques dans la santé, la finance, la cybersécurité et les véhicules autonomes
Les pipelines de données synthétiques font des vagues dans diverses industries en relevant des défis critiques comme la rareté des données, les préoccupations de confidentialité et les déséquilibres des ensembles de données. Examinons de plus près comment ils sont utilisés :
Dans le secteur de la santé, les données synthétiques aident à combler le manque d'informations sur les maladies rares tout en protégeant la confidentialité des patients. Par exemple, des chercheurs en Nouvelle-Zélande ont utilisé des données d'enquête synthétiques pour prédire que les visites chez le médecin généraliste pour les personnes âgées de 65 ans et plus pourraient passer de 8,8 à 15,3 par an dans des scénarios de forte morbidité. Cette information aide à une meilleure allocation des ressources [14]. De plus, les données synthétiques peuvent réduire les biais en suréchantillonnant les groupes sous-représentés [13][14].
Dans le secteur financier, les données synthétiques jouent un rôle clé dans la gestion des risques, l'optimisation de portefeuille et le trading algorithmique, tout en respectant des normes de confidentialité strictes. En suréchantillonnant les classes minoritaires dans les ensembles de données transactionnelles déséquilibrées, les institutions financières amplifient le "signal de fraude" dans les systèmes de détection. Cette approche est particulièrement utile pour traiter la rareté des cas de fraude immobilière, qui manquent souvent de données suffisantes pour entraîner des modèles d'IA efficaces [17][18].
Cybersécurité bénéficie des données synthétiques en équilibrant les ensembles de données pour les systèmes de détection d'intrusions et en générant des entrées adversariales pour tester la sécurité des modèles. Cette "red-teaming" automatisée garantit des mesures de sécurité robustes [13][15]. Parallèlement, dans le développement de véhicules autonomes, les pipelines de données synthétiques réduisent le besoin de données étiquetées de 90 % tout en améliorant les performances des modèles de perception dans des conditions difficiles comme les conditions météorologiques extrêmes ou un éclairage insuffisant [16].
Comparaison des performances : modèles de référence ou modèles de données synthétiques
L'impact des données synthétiques est évident dans leur capacité à améliorer les performances des modèles d'IA. Par exemple, en mars 2024, Jianhao Yuan et ses collègues ont obtenu une précision de classification top-1 de 70,9 % sur ImageNet1K en utilisant uniquement des données synthétiques. La mise à l'échelle du pipeline synthétique au décuple a porté la précision à 76,0 % [2]. De même, les modèles entraînés avec des tomodensitogrammes thoraciques synthétiques conditionnels pour la détection de la COVID-19 ont surpassé ceux entraînés sur des ensembles de données réels limités [14].
Voici une ventilation de la manière dont les données synthétiques résolvent des défis spécifiques dans tous les secteurs :
Secteur | Cas d'utilisation principal | Défi de qualité des données résolu |
|---|---|---|
Santé | Formation de modèles de diagnostic (p. ex., COVID-19) | Pénurie de données et confidentialité des patients [14] |
Finance | Détection de fraude et évaluation des risques | Conformité réglementaire et diversité des types de données [12] |
Cybersécurité | Détection d'intrusions et red-teaming | Ensembles de données déséquilibrés et tests adversariaux [13][15] |
Véhicules autonomes | Entraînement des modèles de perception | Conditions extrêmes et réduction du besoin de données étiquetées[16] |
Les générateurs de données synthétiques basés sur la marge, tels que AIM et MWEM PGM, améliorent encore l'apprentissage automatique en produisant des résultats quasi identiques à ceux obtenus avec des données réelles[19]. En considérant que jusqu'à 80% du temps de développement de l'IA est consacré à la préparation de données réelles[3], les pipelines de données synthétiques révolutionnent la manière dont les organisations abordent l'entraînement des modèles. En résolvant les contraintes de qualité des données, ils permettent non seulement de gagner du temps, mais aussi d'améliorer considérablement l'efficacité de l'IA.
Comment mettre en place des pipelines de données synthétiques
Étapes pour adopter les données synthétiques
Commencez par identifier le problème spécifique que vous essayez de résoudre. S'agit-il de cas limites, de préoccupations liées à la confidentialité ou de déséquilibres dans les données ? Définir clairement cela vous aidera à déterminer l'échelle et le niveau de détail requis, surtout car l'étiquetage manuel des données peut être coûteux et chronophage.
Commencez par une preuve de concept (PoC) utilisant 1 000 à 10 000 enregistrements non sensibles. Des outils open source comme SDV sont excellents pour tester la qualité des données synthétiques avant de passer à l'échelle[1]. En reflétant le schéma de vos données réelles – tout en excluant les identifiants uniques – vous pouvez éviter le surajustement et réduire les risques de confidentialité[20][21]. La génération de données synthétiques peut faire gagner un temps et un effort considérables par rapport aux méthodes manuelles.
Lors du choix des méthodes, les copules gaussiennes sont excellentes pour des références rapides, tandis que les GAN et les VAE sont mieux adaptés pour capturer des relations complexes dans des données tabulaires, textuelles ou image. Validez vos données synthétiques en effectuant des tests statistiques contre des ensembles de validation[5]. Séparez toujours vos données en ensembles d'entraînement et de validation pour éviter la mémorisation [5]. Ce processus peut ensuite alimenter directement une boucle de rétroaction automatisée.
Automatisez les boucles de rétroaction à l'aide d'outils comme les scripts Python ou Airflow pour évaluer la qualité des données synthétiques. Les échantillons qui ne respectent pas les normes de qualité peuvent être automatiquement écartés [20]. Par exemple, en février 2026, Paytient a adopté le système de données synthétiques de Tonic.ai pour traiter des données sensibles de santé et de paiement, ce qui a considérablement amélioré leur efficacité [24]. De même, Flywire a remplacé les scripts manuels par une génération automatisée de données synthétiques, réduisant le temps de mise en place de nouveaux environnements de test de 20 jours à quelques minutes [24].
Lors du passage en production, suivez une approche "Crawl, Walk, Run". Commencez petit avec des ensembles de données gérables et des cycles d'entraînement courts (1 à 10 minutes). Montez progressivement en charge pour gérer des environnements multi-tables plus complexes [22]. Une approche hybride fonctionne souvent le mieux - combinez 70 à 80 % de données réelles de haute qualité avec 20 à 30 % de données synthétiques. Cela garantit le réalisme tout en couvrant les cas limites [1]. Commencez l'entraînement à grande échelle avec des données synthétiques et utilisez des données réelles pour le réglage final afin d'ancrer votre modèle dans la réalité [23].
Bonnes pratiques pour maintenir la qualité
Une fois votre pipeline opérationnel, maintenir la qualité des données est crucial. Évaluez vos données synthétiques selon trois dimensions clés : Fidélité (à quel point elles reflètent les données réelles), Utilité (leur efficacité dans les tâches d'apprentissage automatique en aval), et Confidentialité (en veillant à ce qu'elle protège contre la réidentification). Pour la production, visez une Confidentialité ≥85 %, une Utilité ≥80 % et une Fidélité ≥90 %. De plus, l'appariement univarié devrait dépasser 85 %, les tendances bivariées devraient surpasser 80 %, et le risque de singularisation devrait rester inférieur à 1 % [1].
Maintenez un « Gold Set » - un ensemble de données curé et de haute qualité qui sert de référence pour générer des données synthétiques [1]. Évitez de surajuster vos modèles à l'ensemble du jeu de données. Introduisez plutôt du hasard et du bruit pour capturer les cas limites sans simplement répliquer les motifs courants [21]. Intégrez la Confidentialité Différentielle (DP) pendant l'entraînement pour respecter les normes de conformité RGPD et HIPAA tout en fournissant des assurances mathématiques de désidentification [1].
« Les données synthétiques ne sont pas seulement une alternative mais un composant essentiel pour le développement scalable de l'IA. » – Nascenia [20]
À mesure que vos données de production évoluent, versionnez vos générateurs et surveillez la dérive. Utilisez des plateformes MLOps comme Kubeflow ou Airflow pour automatiser le processus de sélection du meilleur synthétiseur en exécutant des évaluations parallèles de différents modèles [1]. Étiquetez les métadonnées, assurez la compatibilité et enregistrez les données validées dans des formats comme CSV ou JSON pour les intégrer de manière transparente dans vos pipelines d'apprentissage automatique existants.
Conclusion : Résoudre le problème de qualité des données de l'IA avec des pipelines synthétiques
Les pipelines de données synthétiques sont devenus une pierre angulaire pour faire progresser le développement de l'IA. D'ici 2028, environ 80 % des données d'entraînement de l'IA seront synthétiques, une augmentation spectaculaire par rapport à seulement 5 % en 2021 [25]. Ce changement s'attaque à certains des plus grands obstacles de l'IA : disponibilité limitée des données, préoccupations liées à la confidentialité, biais et difficulté à traiter en toute sécurité des cas limites rares. Le résultat ? Des avantages opérationnels et des économies majeurs.
Les organisations qui adoptent des pipelines synthétiques peuvent réduire les coûts jusqu'à 99 % tout en accélérant le déploiement des modèles d'un facteur 10 [1]. Par exemple, l'étiquetage manuel d'un seul cas limite peut coûter 47 000 €, mais la génération de données synthétiques le réduit à seulement 470 € [1]. Un exemple concret vient de GoDaddy, qui en janvier 2026 a rapporté avoir réduit de 90 % le temps consacré à la création de données de test et éliminé entièrement le besoin de données de production dans les environnements de test [26].
Les données synthétiques ne se contentent pas d'atténuer la pénurie ; elles surpassent souvent les données réelles.
- Kalyan Veeramachaneni, chercheur scientifique principal, MIT [25]
Ces avantages se font sentir dans divers secteurs. Dans le domaine de la santé, les pipelines synthétiques permettent la recherche sur les maladies rares tout en garantissant la conformité aux réglementations comme HIPAA. Dans la finance, ils permettent aux institutions de tester des systèmes de détection de fraude à l'aide de millions de transactions synthétiques. Parallèlement, les entreprises de véhicules autonomes peuvent simuler des milliards de kilomètres de conduite dans des conditions qu'il serait impossible de reproduire dans le monde réel [25].
FAQ
Comment les pipelines de données synthétiques protègent-ils la vie privée tout en restant conformes aux réglementations ?
Les pipelines de données synthétiques jouent un rôle crucial dans le maintien de la conformité en matière de protection de la vie privée en utilisant des techniques avancées pour anonymiser les données et protéger les informations sensibles. Ces pipelines créent des données synthétiques qui sont découplées de l'ensemble de données d'origine, ce qui contribue à minimiser les risques de réidentification ou de violation de la vie privée.
Une méthode remarquable est la confidentialité différentielle, un cadre mathématique qui limite la quantité d'informations que les données synthétiques peuvent révéler sur l'ensemble de données d'origine. D'autres techniques, telles que le masquage de la confidentialité et des règles de synthèse soigneusement conçues, garantissent que les données générées restent distinctes des données réelles. Ces mesures sont conçues pour se conformer aux lois sur la protection de la vie privée comme le RGPD et HIPAA, permettant aux organisations d'exploiter des données de haute qualité pour l'entraînement de l'IA tout en restant dans les limites légales et éthiques.
Quels secteurs bénéficient le plus des pipelines de données synthétiques ?
Les pipelines de données synthétiques transforment les secteurs confrontés à des problèmes tels que la disponibilité limitée des données, les restrictions de confidentialité ou la demande d'ensembles de données variés. Prenons l'exemple de la santé et de la recherche biomédicale. Ces domaines s'appuient sur des données synthétiques pour protéger la vie privée des patients tout en faisant progresser l'entraînement des modèles d'IA et les efforts de recherche.
Dans l'industrie manufacturière, les données synthétiques jouent un rôle différent mais tout aussi important. Elles aident à rationaliser les opérations, à améliorer les capacités d'analyse et à réduire les coûts associés à la collecte et à l'étiquetage des données.
Au-delà de ces secteurs, des domaines comme la finance, les télécommunications et les services publicspermettent également d'exploiter les données synthétiques. Cela permet un partage sécurisé des données, aide à réduire les biais et garantit la conformité avec les lois sur la confidentialité. Ces pipelines changent la donne, permettant aux organisations d'accélérer le développement de l'IA, d'améliorer la précision des modèles et d'extraire des informations précieuses à partir de données sensibles ou rares - tout en respectant des exigences strictes en matière de confidentialité.
Comment les pipelines de données synthétiques améliorent-ils les performances des modèles d'IA ?
Les pipelines de données synthétiques jouent un rôle clé dans l'amélioration des performances des modèles d'IA en abordant des problèmes tels que la disponibilité limitée des données et les biais. Ces pipelines créent des ensembles de données bien conçus et représentatifs qui contribuent à améliorer la précision, la cohérence et l'adaptabilité des modèles.
En imitant un large éventail de scénarios, ces systèmes permettent des processus de formation et de test plus rapides, réduisant ainsi la dépendance aux données réelles coûteuses ou difficiles d'accès. Cette approche garantit que les modèles d'IA sont mieux préparés à gérer les complexités du monde réel, ce qui conduit à des prédictions et des résultats plus fiables.
Articles de blog connexes
- Au-delà du cycle de battage médiatique : pourquoi la direction générale privilégie « l'intimité à grande échelle » plutôt que les méga-expositions.
- Le guide du directeur de l'IA : 5 priorités pour les 12 prochains mois.
- Le lien entre énergie et calcul : l'IA peut-elle être durable d'ici 2030 ?
- De la graine à l'échelle : les leçons des nouvelles licornes européennes.