
AI-modellen hebben kwaliteitsdata nodig, maar traditionele methoden kunnen de vraag niet bijbenen. Handmatige dataverzameling is traag, duur en foutgevoelig, terwijl privacywetten zoals GDPR en HIPAA extra complexiteit toevoegen. Synthetische datapijplijnen bieden een oplossing door kunstmatige datasets te genereren die patronen in echte data nabootsen zonder privacyrisico's. Deze pijplijnen besparen tijd, verlagen kosten en verbeteren AI-prestaties. Zo hebben bedrijven als ING België en GoDaddy de tijd voor datavoorbereiding met tot 90% verminderd en boetes voor datamisbruik vermeden. Tegen 2028 zou synthetische data tot 80% van AI-trainingsdata kunnen uitmaken, wat industrieën zoals gezondheidszorg, financiën en autonome voertuigen transformeert.
Belangrijkste punten:
- Dataproblemen: Schaarste, privacyregelgeving en hoge kosten voor handmatige labeling.
- Voordelen van synthetische data: Snellere generatie, lagere kosten (tot 99%) en betere naleving van privacyvoorschriften.
- Praktijkvoorbeelden: ING België creëerde 10.000 betalingsrecords in 2 minuten, wat de efficiëntie van systeemtesten verbeterde.
- Getroffen industrieën: Gezondheidszorg (onderzoek naar zeldzame ziekten), financiën (fraudedetectie), cybersecurity en autonome voertuigen.
Synthetische pijplijnen hervormen AI-ontwikkeling en bieden efficiënte, schaalbare oplossingen voor datakwaliteitsproblemen.
Het bouwen van synthetische datapijplijnen voor open onderzoek en schaalbare AI-ontwikkeling
Hoe synthetische datapijplijnen kwaliteitsproblemen oplossen
Synthetische datapijplijnen zijn ontworpen om kunstmatige datasets te genereren die realistische patronen nabootsen, terwijl gevoelige informatie beschermd blijft. In tegenstelling tot traditionele dataverzamelingsmethoden volgen deze pijplijnen een gestructureerd, meerstapsproces dat generatie, validatie en verfijning omvat. Geavanceerde technieken zoals GAN's (Generative Adversarial Networks), VAE's (Variational Autoencoders) en grote taalmodellen worden vaak gebruikt om deze data te creëren. Rigoureuze kwaliteitscontroles verifiëren vervolgens statistische nauwkeurigheid en naleving van privacynormen, waardoor de data zowel betrouwbaar als veilig is [5][1]. Laten we uitleggen hoe deze pijplijnen werken en welke praktische voordelen ze opleveren.
Wat zijn synthetische datapijplijnen?
Een synthetische datapijplijn is een geautomatiseerd systeem dat systematisch kunstmatige datasets produceert via een gecontroleerde reeks stappen. Het proces begint met datageneratie, waarbij algoritmen realistische patronen analyseren en nieuwe records genereren die statistische relaties behouden. Vervolgens wordt de validatie fase meet hoe nauw de synthetische data aansluit bij de oorspronkelijke dataset. Idealiter zou de synthetische data de natuurlijke variatie moeten weerspiegelen die wordt gevonden tussen trainings- en holdout-sets [5].
De laatste fase is geautomatiseerde verfijning, die drie belangrijke soorten filtering omvat: basiskwaliteitscontroles, het waarborgen van labelconsistentie en het afstemmen van de dataverdeling. Deze gestructureerde aanpak pakt direct veelvoorkomende datakwaliteitsproblemen aan. Zo paste MOSTLY AI in 2023 dit raamwerk toe op de UCI Adult Income-dataset (39.074 records). Door de data te splitsen in trainings- en holdout-sets en de Total Variational Distance te meten, behaalden zij een gemiddelde algehele nauwkeurigheid van 98,3% - met 98,9% univariate nauwkeurigheid en 97,7% bivariate nauwkeurigheid voor de synthetische dataset [5]. Dit robuuste proces garandeert niet alleen statistische precisie, maar levert ook praktische, meetbare resultaten op.
Voordelen van het gebruik van synthetische data
Synthetische datapijplijnen bieden duidelijke oplossingen voor veelvoorkomende datakwaliteitsuitdagingen en leveren voordelen die zowel significant als meetbaar zijn. Een groot voordeel is hun vermogen om schaarste aan randgevallen aan te pakken. In tegenstelling tot handmatige labeling, die duur en tijdrovend kan zijn [1], verlaagt synthetische generatie de kosten drastisch. Zo gebruikte ING België in januari 2026 de Synthetic Data Vault (SDV) om in slechts 2 minuten 10.000 synthetische betalingsgegevens te creëren. Deze aanpak verhoogde de testdekking voor hun SEPA-betalingsverwerkingssysteem met 100 keer, terwijl er slechts een fractie van de eerder benodigde handmatige inspanning nodig was [1].
Een ander belangrijk voordeel is verbeterde naleving van de privacywetgeving door het gebruik van Differential Privacy (DP). In tegenstelling tot traditionele anonimiseringstechnieken bieden DP-pijplijnen wiskundige garanties voor de-identificatie van data, in lijn met de "Privacy by Design"-principes van de AVG [1]. Enterprise-grade oplossingen kunnen tot 97,8% nauwkeurigheid behalen bij het behouden van statistische relaties, terwijl ze privacybescherming waarborgen [1]. Dit is bijzonder belangrijk gezien de financiële risico's van niet-naleving - AVG-boetes kunnen oplopen tot meer dan €20 miljoen, en HIPAA-inbreuken kosten gemiddeld nu €10,4 miljoen per incident [1].
Tot slot versnellen synthetische datapijplijnen de ontwikkeling en verlagen ze de kosten aanzienlijk. Organisaties die synthetische data gebruiken, rapporteren kostenverlagingen tot 99% en een vertienvoudiging van de snelheid van modelimplementatie [1]. Tegen 2026 zal synthetische data naar verwachting 60% van alle AI-trainingsdata uitmaken [1]. Deze combinatie van snelheid, betaalbaarheid en regulatorische afstemming maakt synthetische pijplijnen een essentieel onderdeel van moderne AI-ontwikkeling.
Een Synthetische Datapijplijn Bouwen
Het creëren van een synthetische datapijplijn stelt je in staat om de voordelen van synthetische data om te zetten in praktische workflows. Dit proces omvat een reeks onderling verbonden fasen, die elk een cruciale rol spelen in het succes van de pijplijn. Laten we deze fasen en de technologieën die kunnen helpen bij het bouwen van een betrouwbaar systeem opsplitsen.
Hoofdfasen van een Synthetische Datapijplijn
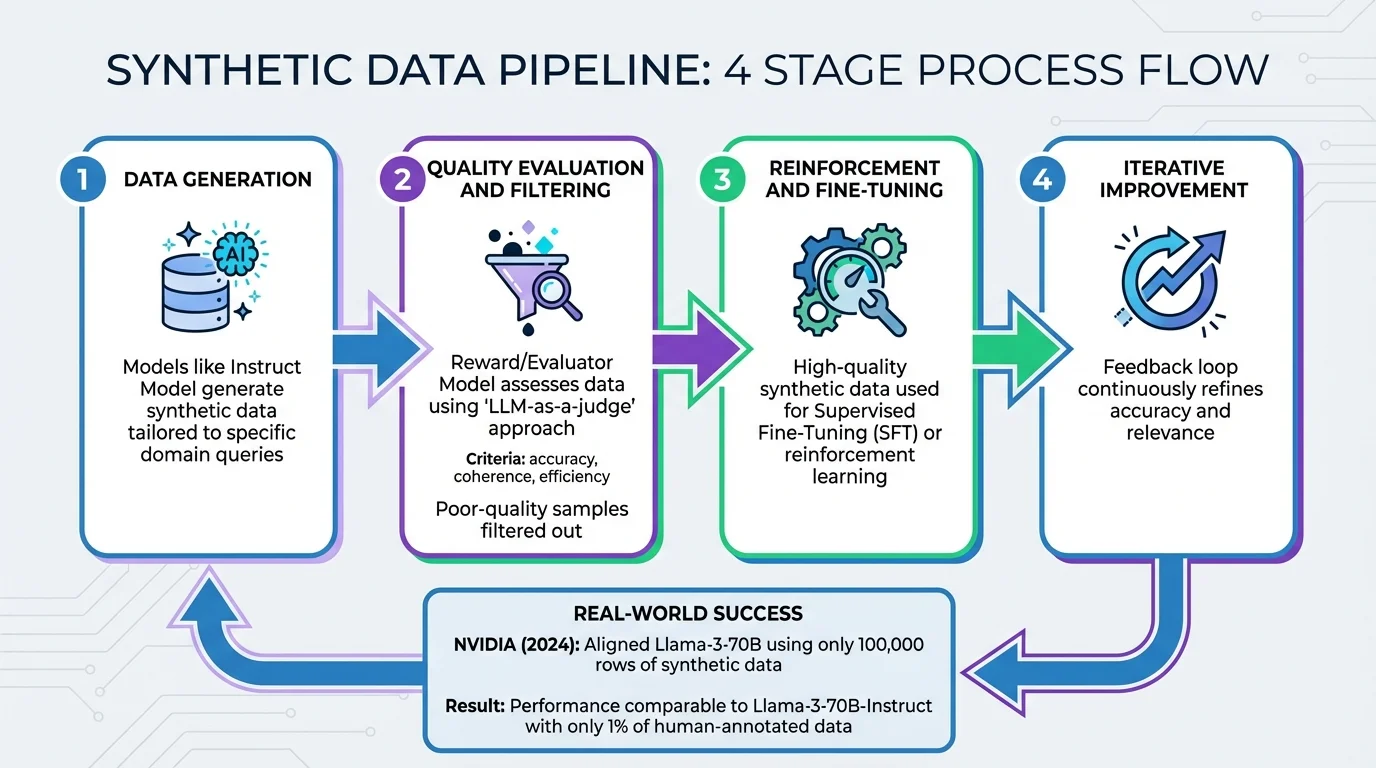
Een goed gestructureerde pijplijn omvat doorgaans vier belangrijke fasen:
- Data Generatie: Dit is waar synthetische data wordt gecreëerd. Modellen zoals een Instruct Model worden gebruikt om data te genereren die is afgestemd op specifieke domeinvragen [7].
- Kwaliteitsevaluatie en Filtering: In deze fase beoordeelt een Reward- of Evaluatormodel de synthetische data op criteria zoals nauwkeurigheid, coherentie en efficiëntie [6][7]. Deze aanpak, vaak aangeduid als "LLM-as-a-judge", automatiseert het scoren en rangschikken van synthetische samples, waardoor dure menselijke annotatie niet nodig is. Samples van slechte kwaliteit worden uitgefilterd [6][7].
- Versterking en Fine-Tuning: Hoogwaardige synthetische data uit de vorige fase wordt gebruikt voor Supervised Fine-Tuning (SFT) of reinforcement learning-technieken om het model verder te verbeteren.
- Iteratieve Verbetering: Deze stap introduceert een feedbacklus om de nauwkeurigheid en relevantie van de synthetische data continu te verfijnen [6].
Een opmerkelijk voorbeeld van dit proces in actie komt van NVIDIA in 2024. Ze stemden hun Llama-3-70B-basismodel af met slechts 100.000 rijen synthetische conversatiedata (het zogenaamde "Daring Anteater"-dataset). Deze aanpak behaalde prestaties vergelijkbaar met Llama-3-70B-Instruct terwijl er slechts 1% van de menselijk geannoteerde data werd gebruikt [7]. Dit laat zien hoe een goed ontworpen pipeline de behoefte aan handmatige labeling aanzienlijk kan verminderen zonder in te leveren op prestaties.
Tools en technologieën die u kunt gebruiken
Het succes van elke fase hangt sterk af van het kiezen van de juiste tools. Hier is een overzicht van enkele beschikbare opties:
- Generatietechnologieën:
- Generative Adversarial Networks (GAN's) zijn ideaal voor het creëren van hoogwaardige afbeeldingen.
- Variational Autoencoders (VAE's) zijn effectief voor stabiele anomaliedetectie.
- Grote taalmodellen zoals Claude 3.7, Llama 3 en GPT-o3 blinken uit in tekst- en codegeneratie.
- Diffusiemodellen winnen terrein voor het produceren van hoogwaardige visuals en het verfijnen van gestructureerde gegevens [4][11].
- Pipeline-orchestratie en -beheer:
- Apache Airflow en Dagster maken geautomatiseerde planning en monitoring van workflows mogelijk [10].
- Databricks Unity Catalog biedt gecentraliseerd beheer voor synthetische gegevens en AI-modellen.
- DreamFactory vereenvoudigt het creëren van beveiligde REST API's om synthetische gegevensbronnen te verbinden met trainingsomgevingen zonder handmatig coderen [4][9].
- CI/CD-tools automatiseren het leveren van datasets voor testdoeleinden [8].
Wat tools betreft, kunt u kiezen tussen open-source en commerciële opties op basis van uw behoeften:
- Open-source tools zoals SDV (Synthetic Data Vault), Apache Airflow en Faker zijn gratis en uitstekend voor onderzoek of prototyping [10][1].
- Voor vereisten op ondernemingsniveau bieden oplossingen zoals Gretel Synthetics beheerde platforms met prijzen die variëren van €280 tot meer dan €9.500 per maand. NVIDIA's Nemotron-4 340B, beschikbaar onder een permissieve licentie, is een andere sterke optie voor commercieel gebruik [1][6].
De meest succesvolle implementaties gebruiken een "Core-Expansion"-strategie, waarbij 70–80% hoogwaardige door mensen gegenereerde data wordt gecombineerd met 20–30% synthetische data. Deze aanpak zorgt voor een nauwkeurige datadistributie en dekt tegelijkertijd edge-cases [1].
"Hoogwaardige trainingsdata speelt een cruciale rol in de prestaties, nauwkeurigheid en kwaliteit van reacties van een aangepast LLM - maar robuuste datasets kunnen onbetaalbaar duur en moeilijk toegankelijk zijn." - NVIDIA [6]
Toepassingen en casestudy's in de industrie
Synthetische data in de gezondheidszorg, financiën, cybersecurity en autonome voertuigen
Synthetische datapijplijnen maken golven in verschillende industrieën door kritieke uitdagingen zoals datatekort, privacyzorgen en dataset-onevenwichten aan te pakken. Laten we eens nader bekijken hoe ze worden gebruikt:
In gezondheidszorg, helpt synthetische data het gebrek aan informatie over zeldzame ziekten aan te pakken en tegelijkertijd de privacy van patiënten te waarborgen. Onderzoekers in Nieuw-Zeeland gebruikten bijvoorbeeld synthetische enquêtedata om te voorspellen dat huisartsenbezoeken voor personen van 65+ jaarlijks zouden kunnen stijgen van 8,8 naar 15,3 in scenario's met hoge morbiditeit. Dit inzicht helpt bij een betere toewijzing van middelen [14]. Bovendien kan synthetische data vooroordelen verminderen door ondervertegenwoordigde groepen te oversamplen [13][14].
In de financiële sector, speelt synthetische data een sleutelrol in risicobeheer, portefeuilleoptimalisatie en algoritmische handel, terwijl strikte privacynormen worden nageleefd. Door minderheidsklassen in onevenwichtige transactiedatasets te upsampelen, versterken financiële instellingen het "fraudesignaal" in detectiesystemen. Deze aanpak is bijzonder nuttig voor het aanpakken van de zeldzaamheid van vastgoedfraudezaken, die vaak onvoldoende data hebben om effectieve AI-modellen te trainen [17][18].
Cybersecurity profiteert van synthetische data door datasets in balans te brengen voor inbraakdetectiesystemen en door adversariële inputs te genereren om de veiligheid van modellen te testen. Deze geautomatiseerde "red-teaming" zorgt voor robuuste beveiligingsmaatregelen [13][15]. Ondertussen, in ontwikkeling van autonome voertuigen, verminderen synthetische datapijplijnen de behoefte aan gelabelde data met 90% terwijl ze de prestaties van perceptiemodellen verbeteren onder uitdagende omstandigheden zoals extreem weer of slechte belichting [16].
Prestatievergelijking: Baseline versus modellen met synthetische data
De impact van synthetische data blijkt duidelijk uit het vermogen om de prestaties van AI-modellen te verbeteren. In maart 2024 bereikten Jianhao Yuan en collega's bijvoorbeeld een top-1 classificatienauwkeurigheid van 70,9% op ImageNet1K met uitsluitend synthetische data. Door de synthetische pijplijn tienvoudig op te schalen steeg de nauwkeurigheid naar 76,0% [2]. Op dezelfde manier presteerden modellen die waren getraind met conditionele synthetische chest-CT-scans voor COVID-19-detectie beter dan modellen die waren getraind op beperkte real-world datasets [14].
Hier is een overzicht van hoe synthetische data specifieke uitdagingen in verschillende sectoren oplost:
Sector | Primair gebruiksscenario | Opgeloste uitdaging op het gebied van datakwaliteit |
|---|---|---|
Gezondheidszorg | Training van diagnostische modellen (bijv. COVID-19) | Dataschaarste en patiëntprivacy [14] |
Financiën | Fraudedetectie en risicobeoordeling | Naleving van regelgeving en diverse datatypes [12] |
Cybersecurity | Inbraakdetectie en red-teaming | |
Autonome voertuigen | Training van perceptiemodellen | Extreme omstandigheden en verminderde behoefte aan gelabelde gegevens[16] |
Marginale synthetische datageneratoren, zoals AIM en MWEM PGM, verbeteren machine learning verder door resultaten te leveren die bijna identiek zijn aan training op echte gegevens[19]. Gezien het feit dat tot 80% van de AI-ontwikkelingstijd wordt besteed aan het voorbereiden van echte gegevens[3], zorgen synthetische datapijplijnen voor een revolutie in de manier waarop organisaties modeltraining benaderen. Door datakwaliteitsbeperkingen aan te pakken, besparen ze niet alleen tijd, maar leveren ze ook aanzienlijke verbeteringen in AI-effectiviteit op.
Hoe synthetische datapijplijnen te implementeren
Stappen om synthetische gegevens te gebruiken
Begin met het identificeren van het specifieke probleem dat u probeert op te lossen. Heeft u te maken met randgevallen, privacykwesties of gegevensonevenwichtigheden? Een duidelijke definitie hiervan helpt u bij het bepalen van de schaal en het detailniveau dat nodig is, vooral omdat het handmatig labelen van gegevens duur en tijdrovend kan zijn.
Begin met een Proof of Concept (PoC) met 1.000 tot 10.000 niet-gevoelige records. Opensource-tools zoals SDV zijn geweldig voor het testen van de kwaliteit van synthetische gegevens voordat u opschaalt[1]. Door het schema van uw echte gegevens te spiegelen - met uitsluiting van unieke identificatiegegevens - kunt u overfitting voorkomen en privacyrisico's verminderen[20][21]. Synthetische datageneratie kan aanzienlijke tijd en moeite besparen in vergelijking met handmatige methoden.
Bij het kiezen van methoden zijn Gaussiaanse copula's uitstekend voor snelle basislijnen, terwijl GAN's en VAE's beter geschikt zijn voor het vastleggen van complexe relaties in tabel-, tekst- of beeldgegevens. Valideer uw synthetische gegevens door statistische tests uit te voeren op holdout-sets[5]. Splits altijd je gegevens in trainings- en validatiesets om memorisatie te voorkomen [5]. Dit proces kan vervolgens direct worden gevoed in een geautomatiseerde feedbacklus.
Automatiseer feedbacklussen met behulp van tools zoals Python-scripts of Airflow om de kwaliteit van de synthetische gegevens te evalueren. Samples die niet aan de kwaliteitsnormen voldoen, kunnen automatisch worden weggegooid [20]. Zo adopteerde Paytient in februari 2026 het synthetische gegevenssysteem van Tonic.ai voor het verwerken van gevoelige gezondheids- en betalingsgegevens, wat hun efficiëntie aanzienlijk verbeterde [24]. Evenzo verving Flywire handmatige scripts door geautomatiseerde synthetische gegevensgeneratie, waardoor de tijd om nieuwe testomgevingen op te zetten werd teruggebracht van 20 dagen tot slechts enkele minuten [24].
Wanneer je naar productie gaat, volg dan een "Kruipen, Lopen, Rennen"-aanpak. Begin klein met beheersbare datasets en korte trainingscycli (1 tot 10 minuten). Schaal geleidelijk op om complexere omgevingen met meerdere tabellen aan te kunnen [22]. Een hybride aanpak werkt vaak het beste - combineer 70–80% hoogwaardige echte gegevens met 20–30% synthetische gegevens. Dit zorgt voor realisme terwijl randgevallen worden afgedekt [1]. Begin grootschalige training met synthetische gegevens en gebruik echte gegevens voor de laatste fine-tuning om je model in de werkelijkheid te verankeren [23].
Best Practices voor het Handhaven van Kwaliteit
Zodra je pipeline operationeel is, is het handhaven van gegevenskwaliteit cruciaal. Evalueer je synthetische gegevens op drie belangrijke dimensies: getrouwheid (hoe nauw het echte gegevens weerspiegelt), bruikbaarheid (de effectiviteit in stroomafwaartse machine learning-taken), en Privacy (ervoor zorgen dat het beschermt tegen heridentificatie). Streef voor productie naar Privacy ≥85%, Nut ≥80% en Getrouwheid ≥90%. Bovendien moet univariate matching boven 85% uitkomen, moeten bivariate trends 80% overschrijden en moet het risico op singling-out onder 1% blijven [1].
Onderhoud een "Gold Set" - een samengestelde, hoogwaardige dataset die dient als benchmark voor het genereren van synthetische data [1]. Vermijd overmatig afstemmen van je modellen op de volledige dataset. Introduceer in plaats daarvan willekeur en ruis om edge cases vast te leggen zonder simpelweg veelvoorkomende patronen te repliceren [21]. Voeg Differential Privacy (DP) toe tijdens de training om te voldoen aan de GDPR- en HIPAA-normen en tegelijkertijd wiskundige garanties voor de-identificatie te bieden [1].
"Synthetische data is niet alleen een alternatief, maar een kerncomponent voor schaalbare AI-ontwikkeling." – Nascenia [20]
Naarmate je productiedata evolueert, versioneer je generators en monitor op drift. Gebruik MLOps-platforms zoals Kubeflow of Airflow om het proces van het selecteren van de beste synthesizer te automatiseren door parallelle evaluaties van verschillende modellen uit te voeren [1]. Tag metadata, zorg voor compatibiliteit en sla gevalideerde data op in formaten zoals CSV of JSON om naadloos te integreren in je bestaande machine learning-pipelines.
Conclusie: Het datakwaliteitsprobleem van AI oplossen met synthetische pipelines
Synthetische datapipelines zijn een hoeksteen geworden voor het bevorderen van AI-ontwikkeling. Naar schatting zal in 2028 80% van de AI-trainingsdata synthetisch zijn, een dramatische stijging ten opzichte van slechts 5% in 2021 [25]. Deze verschuiving pakt enkele van de grootste obstakels van AI aan: beperkte beschikbaarheid van data, privacykwesties, bias en de moeilijkheid om zeldzame edge cases veilig aan te pakken. Het resultaat? Grote operationele voordelen en kostenbesparingen.
Organisaties die synthetische pipelines adopteren, kunnen kosten met maar liefst 99% verlagen terwijl ze modelimplementatie met een factor 10 versnellen [1]. Het handmatig labelen van één edge case kan bijvoorbeeld €47.000 kosten, maar synthetische datageneratie reduceert dat tot slechts €470 [1]. Een praktijkvoorbeeld komt van GoDaddy, dat in januari 2026 meldde de tijd besteed aan het creëren van testdata met 90% te hebben verminderd en de behoefte aan productiedata in testomgevingen volledig te hebben geëlimineerd [26].
Synthetische data verlichten niet alleen schaarste, maar presteren vaak beter dan echte data.
- Kalyan Veeramachaneni, Principal Research Scientist, MIT[25]
Deze voordelen worden in uiteenlopende sectoren gevoeld. In de gezondheidszorg maken synthetische pipelines onderzoek naar zeldzame ziekten mogelijk, terwijl naleving van regelgeving zoals HIPAA wordt gewaarborgd. In de financiële sector kunnen instellingen fraudedetectiesystemen testen met miljoenen synthetische transacties. Ondertussen kunnen bedrijven in autonome voertuigen miljarden kilometers aan rijervaring simuleren onder omstandigheden die in de echte wereld onmogelijk te repliceren zouden zijn[25].
Veelgestelde vragen
Hoe beschermen synthetische datapipelines de privacy terwijl ze voldoen aan regelgeving?
Synthetische datapipelines spelen een cruciale rol bij het waarborgen van privacy-compliance door geavanceerde technieken te gebruiken om gegevens te anonimiseren en gevoelige informatie te beschermen. Deze pipelines creëren synthetische data die ontkoppeld is van de oorspronkelijke dataset, wat helpt om de kans op heridentificatie of privacyschendingen te minimaliseren.
Een opvallende methode is differentiële privacy, een wiskundig raamwerk dat beperkt hoeveel informatie synthetische data over de oorspronkelijke dataset kunnen onthullen. Andere technieken, zoals privacymaskering en zorgvuldig ontworpen syntheseregels, zorgen ervoor dat de gegenereerde data duidelijk verschillen van echte data. Deze maatregelen zijn ontwikkeld om te voldoen aan privacywetten zoals GDPR en HIPAA, waardoor organisaties hoogwaardige data kunnen benutten voor AI-training terwijl ze binnen wettelijke en ethische grenzen blijven.
Welke sectoren hebben het meeste baat bij synthetische datapipelines?
Synthetische datapipelines hervormen sectoren die worstelen met problemen zoals beperkte beschikbaarheid van data, privacybeperkingen of de vraag naar uiteenlopende datasets. Neem gezondheidszorg en biomedisch onderzoek, bijvoorbeeld. Deze vakgebieden vertrouwen op synthetische data om de privacy van patiënten te beschermen terwijl ze AI-modeltraining en onderzoeksinspanningen bevorderen.
In productie speelt synthetische data een andere maar even belangrijke rol. Het helpt bij het stroomlijnen van operaties, het verbeteren van analysemogelijkheden en het verlagen van de kosten die gepaard gaan met het verzamelen en labelen van data.
Daarnaast profiteren sectoren zoals financiën, telecommunicatie en publieke diensten ook profiteren van synthetische data. Het maakt veilig datadelen mogelijk, helpt vooroordelen te verminderen en zorgt voor naleving van privacywetgeving. Deze pijplijnen zijn een gamechanger, waardoor organisaties de AI-ontwikkeling kunnen versnellen, de precisie van modellen kunnen verbeteren en waardevolle inzichten kunnen extraheren uit gevoelige of schaarse datasets – alles terwijl ze voldoen aan strenge privacyvereisten.
Hoe verbeteren synthetische datapijplijnen de prestaties van AI-modellen?
Synthetische datapijplijnen spelen een sleutelrol bij het verbeteren van de prestaties van AI-modellen door problemen zoals beperkte databeschikbaarheid en vooroordelen aan te pakken. Deze pijplijnen creëren zorgvuldig opgebouwde, representatieve datasets die helpen de precisie, consistentie en aanpasbaarheid van modellen te verbeteren.
Door een breed scala aan scenario's na te bootsen, maken deze systemen snellere trainings- en testprocessen mogelijk, waardoor de afhankelijkheid van dure of moeilijk toegankelijke real-world data afneemt. Deze aanpak zorgt ervoor dat AI-modellen beter zijn voorbereid om complexiteiten in de echte wereld te beheren, wat leidt tot betrouwbaardere voorspellingen en resultaten.