
AI模型需要高质量数据,但传统方法无法跟上需求。人工数据收集速度慢、成本高且容易出错,而GDPR和HIPAA等隐私法规又增加了复杂性。合成数据管道通过生成模拟真实数据模式且无隐私风险的人工数据集,提供了解决方案。这些管道可节省时间、降低成本并提升AI性能。例如,像ING Belgium和GoDaddy这样的公司已将数据准备时间缩短多达90%,并避免了因数据滥用而被罚款。到2028年,合成数据可能占AI训练数据的80%,从而变革医疗、金融和自动驾驶等行业。
关键要点:
- 数据挑战:数据稀缺、隐私法规以及高昂的人工标注成本。
- 合成数据的优势:更快的生成速度、更低的成本(最高可降低99%)以及更好的隐私合规性。
- 真实案例:ING Belgium在2分钟内创建了10,000条支付记录,提升了系统测试效率。
- 受影响的行业:医疗(罕见病研究)、金融(欺诈检测)、网络安全和自动驾驶。
合成数据管道正在重塑AI开发,为数据质量问题提供高效、可扩展的解决方案。
为开放研究和可扩展AI开发构建合成数据管道
合成数据管道如何解决质量问题
合成数据管道旨在生成模拟真实世界模式的人工数据集,同时确保敏感信息受到保护。与传统数据收集方法不同,这些管道遵循结构化的多步骤流程,包括生成、验证和优化。通常会采用GAN(生成对抗网络)、VAE(变分自编码器)和大型语言模型等先进技术来创建这些数据。随后通过严格的质量检查来验证统计准确性和隐私标准合规性,确保数据既可靠又安全 [5][1]。下面我们来拆解这些管道的工作方式及其带来的实际优势。
什么是合成数据管道?
合成数据管道是一种自动化系统,通过一系列受控步骤系统地生成人工数据集。该过程从数据生成开始,算法会分析真实世界模式并生成保持统计关系的新记录。随后,验证阶段衡量合成数据与原始数据集的匹配程度。理想情况下,合成数据应反映训练集与保留集之间发现的自然方差[5]。
最后阶段是自动优化,包括三种关键类型的过滤:基本质量检查、确保标签一致性以及调整数据分布。这种结构化方法直接解决了常见的数据质量问题。例如,2023年,MOSTLY AI将该框架应用于UCI成人收入数据集(39,074条记录)。通过将数据分为训练集和保留集并测量总变差距离,他们实现了平均总体准确率98.3%——其中合成数据集的单变量准确率为98.9%,双变量准确率为97.7%[5]。这一稳健的过程不仅保证了统计精度,还提供了实用、可衡量的成果。
使用合成数据的好处
合成数据管道为常见的数据质量挑战提供了明确的解决方案,其益处既显著又可衡量。一个主要优势是它们能够解决边缘案例稀缺问题。与人工标注相比,人工标注可能昂贵且耗时[1],合成生成大幅降低了成本。例如,2026年1月,ING比利时使用Synthetic Data Vault(SDV)在仅2分钟内创建了10,000条合成支付记录。这种方法将其SEPA支付处理系统的测试覆盖率提高了100倍,同时仅需此前所需人工工作量的一小部分[1]。
另一个关键优势是通过使用差分隐私(DP)实现增强的隐私合规性。与传统匿名化技术不同,支持DP的管道提供了数据去标识化的数学保证,符合GDPR的“隐私设计”原则[1]。企业级解决方案在保持隐私保护的同时,可实现高达97.8%的统计关系保真度[1]。这一点尤其重要,因为不合规会带来财务风险——GDPR罚款可超过2000万欧元,而HIPAA违规目前平均每次事件造成1040万欧元的损失[1]。
最后,合成数据管道能够加速开发并显著降低成本。利用合成数据的组织报告成本降低高达99%,模型部署速度提升十倍[1]。预计到2026年,合成数据将占所有AI训练数据的60%[1]。速度、成本效益与监管合规性的结合,使合成管道成为现代AI开发不可或缺的组成部分。
构建合成数据管道
创建合成数据管道可以将合成数据的优势转化为实际工作流程。这一过程涉及一系列相互关联的阶段,每个阶段对确保管道的成功都起着关键作用。让我们来分解这些阶段,以及能够帮助您构建可靠系统的相关技术。
合成数据管道的主要阶段
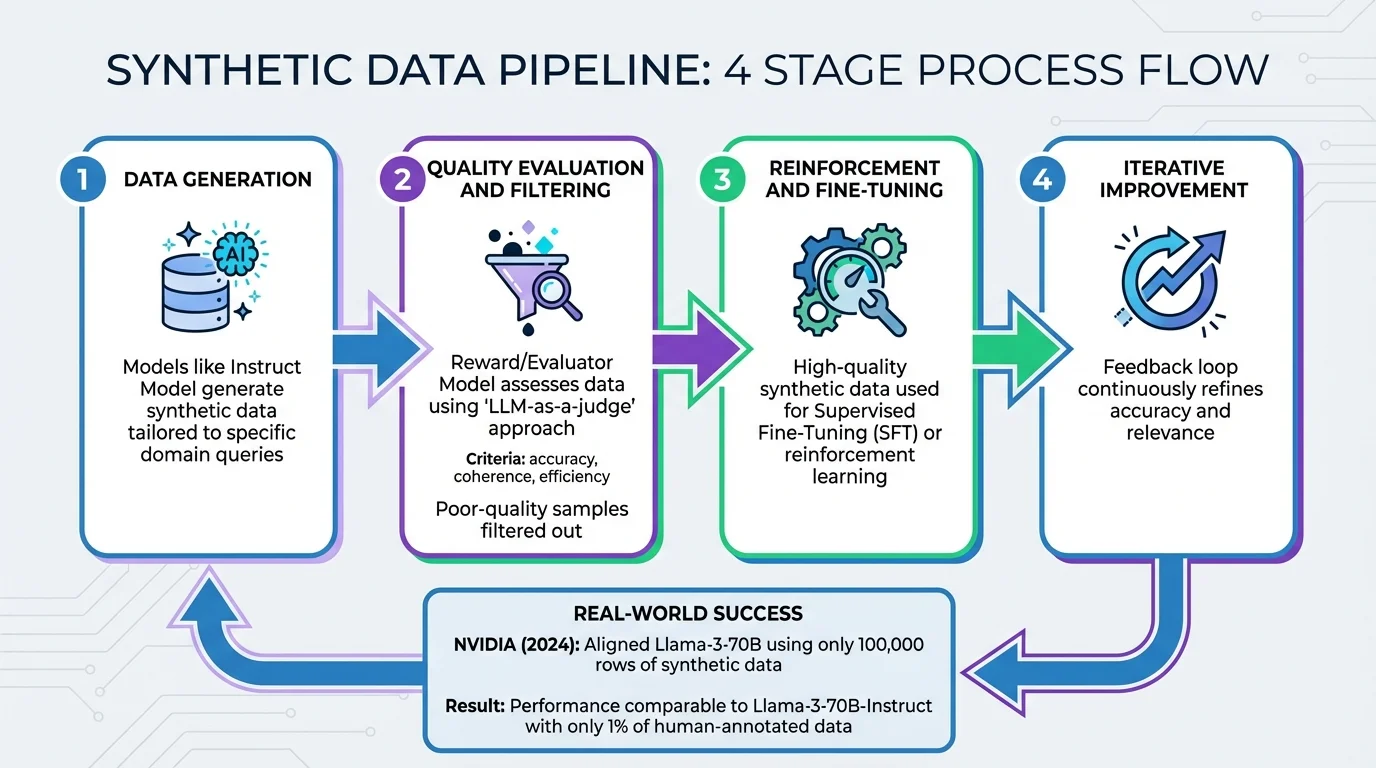
一个结构良好的管道通常包括四个关键阶段:
- 数据生成:这是创建合成数据的环节。像指令模型这样的模型被用于生成针对特定领域查询定制的数据[7]。
- 质量评估与过滤:在此阶段,奖励模型或评估模型会根据准确性、连贯性和效率等标准对合成数据进行评估[6][7]。这种方法通常被称为“LLM-as-a-judge”(以LLM为裁判),它自动对合成样本进行评分和排序,省去了昂贵的人工标注需求。质量较差的样本会被过滤掉[6][7]。
- 强化与微调:来自前一阶段的高质量合成数据被用于监督式微调(SFT)或强化学习技术,以进一步优化模型。
- 迭代改进:此步骤引入反馈循环,以持续优化合成数据的准确性和相关性[6]。
这一过程的一个显著实例来自2024年的NVIDIA。他们仅使用10万行合成对话数据(被称为“Daring Anteater”数据集)对齐了Llama-3-70B基础模型。这种方法在仅依赖1%的人工标注数据的情况下,实现了与Llama-3-70B-Instruct相当的性能[7]。这表明,设计良好的流水线可以显著减少对手动标注的需求,同时不会牺牲性能。
您可以使用的工具和技术
每个阶段的成功很大程度上取决于选择合适的工具。以下是一些可用选项:
- 生成技术:
- 流水线编排与管理:
- Apache Airflow和Dagster允许自动化调度和监控工作流[10]。
- DatabricksUnity Catalog为合成数据和AI模型提供集中治理。
- DreamFactory简化了安全REST API的创建,以便在没有手动编码的情况下将合成数据源连接到训练环境[4][9]。
- CI/CD工具自动化测试数据集的供应[8]。
在工具方面,您可以根据需求在开源和商业选项之间进行选择:
- 像SDV(Synthetic Data Vault)、Apache Airflow和Faker 免费且非常适合研究或原型开发 [10][1]。
- 对于企业级需求,像 Gretel Synthetics 这样的解决方案提供了托管平台,定价从每月 €280 到超过 €9,500 不等。NVIDIA 的 Nemotron-4 340B 采用宽松许可证,是另一个适合商业用途的有力选择 [1][6]。
大多数成功的实施采用“核心-扩展”策略,将 70–80% 的高质量人工生成数据与 20–30% 的合成数据相结合。这种方法既能确保准确的数据分布,又能覆盖边缘情况 [1]。
“高质量的训练数据在自定义 LLM 的性能、准确性和响应质量中发挥着关键作用——但稳健的数据集可能过于昂贵且难以获取。”——NVIDIA [6]
行业应用与案例研究
医疗、金融、网络安全和自动驾驶中的合成数据
合成数据管道正在各行业引起广泛关注,解决了数据稀缺、隐私顾虑和数据集不平衡等关键挑战。让我们更详细地看看它们的应用:
在医疗保健领域,合成数据有助于解决罕见疾病信息缺乏的问题,同时保护患者隐私。例如,新西兰的研究人员使用合成调查数据预测,在高发病率情景下,65 岁以上人群的全科医生就诊次数可能从每年 8.8 次增加到 15.3 次。这一洞察有助于更好地分配资源 [14]。此外,合成数据可以通过对代表性不足群体进行过采样来减少偏差 [13][14]。
在金融领域,合成数据在风险管理、投资组合优化和算法交易中发挥着关键作用,同时满足严格的隐私标准。通过对不平衡交易数据集中的少数类进行上采样,金融机构增强了检测系统中的“欺诈信号”。这种方法特别有助于解决财产欺诈案件稀少的问题,这些案件往往缺乏足够的数据来训练有效的 AI 模型 [17][18]。
网络安全通过平衡入侵检测系统的数据集并生成对抗性输入来测试模型安全性,从而从合成数据中受益。这种自动化的“红队测试”确保了稳健的安全措施[13][15]。与此同时,在自动驾驶汽车开发中,合成数据管道将标注数据的需求减少了90%,同时在极端天气或光线不足等挑战性条件下提高了感知模型的性能[16]。
性能比较:基线模型与合成数据模型
合成数据的影响体现在其提升AI模型性能的能力上。例如,2024年3月,Jianhao Yuan及其同事仅使用合成数据在ImageNet1K上实现了70.9%的top-1分类准确率。将合成管道扩大十倍后,准确率提升至76.0%[2]。同样,使用条件合成胸部CT扫描进行COVID-19检测训练的模型,其性能优于在有限真实世界数据集上训练的模型[14]。
以下是对合成数据如何解决各行业具体挑战的分解:
行业 | 主要用例 | 解决的数据质量挑战 |
|---|---|---|
医疗保健 | 诊断模型训练(如COVID-19) | 数据稀缺和患者隐私 [14] |
金融 | 欺诈检测与风险评估 | 监管合规和多样化数据类型 [12] |
网络安全 | 入侵检测与红队测试 | |
自动驾驶车辆 | 感知模型训练 | 极端条件与减少标注数据的需求[16] |
基于边际的合成数据生成器,如AIM和MWEM PGM,通过提供与真实数据训练结果几乎相同的效果,进一步增强了机器学习能力[19]。考虑到AI开发时间中高达80%用于准备真实数据[3],合成数据管道正在彻底改变组织进行模型训练的方式。通过解决数据质量约束,它们不仅节省了时间,还显著提升了AI的有效性。
如何实施合成数据管道
采用合成数据的步骤
首先,确定您要解决的具体问题。您是否在处理边缘情况、隐私问题或数据不平衡?明确界定这些将帮助您确定所需的数据规模与详细程度,尤其是因为手动标注数据可能既昂贵又耗时。
从使用1,000到10,000条非敏感记录开始概念验证(PoC)。像SDV这样的开源工具非常适合在扩展前测试合成数据的质量[1]。通过镜像真实数据的模式——同时排除唯一标识符——您可以避免过拟合并降低隐私风险[20][21]。与手动方法相比,合成数据生成可以节省大量时间和精力。
在选择方法时,高斯Copulas非常适合快速建立基线,而GANs和VAEs更适合捕获表格、文本或图像数据中的复杂关系。通过针对保留集运行统计检验来验证您的合成数据[5]. 始终将数据划分为训练集和留出集,以防止记忆 [5]。然后,这一流程可以直接接入自动化反馈循环。
自动化反馈循环,使用 Python 脚本或 Airflow 等工具评估合成数据的质量。不符合质量标准的样本可以自动丢弃 [20]。例如,在 2026 年 2 月,Paytient 采用了 Tonic.ai 的合成数据系统来处理敏感的健康和支付数据,显著提升了效率 [24]。同样,Flywire 用自动化合成数据生成取代了手动脚本,将搭建新测试环境的时间从 20 天缩短到仅几分钟 [24]。
在投入生产时,请遵循“爬行、行走、奔跑”的方法。从可管理的数据集和较短的训练周期(1 到 10 分钟)开始,逐步扩展以处理更复杂的多表环境 [22]。混合方法通常效果最佳——将 70–80% 的高质量真实数据与 20–30% 的合成数据相结合。这样既能确保真实性,又能覆盖边缘情况 [1]。先使用合成数据进行大规模训练,再用真实数据进行最终微调,使您的模型扎根于现实 [23]。
维护质量的最佳实践
流水线运行起来后,维护数据质量至关重要。请从三个关键维度评估您的合成数据:保真度(它与真实世界数据的接近程度)、实用性(它在下游机器学习任务中的有效性),以及 隐私(确保其能够防止重新识别)。对于生产环境,目标应为隐私≥85%,效用≥80%,保真度≥90%。此外,单变量匹配应超过85%,双变量趋势应超过80%,且单独识别风险应保持在1%以下[1]。
维护一个“黄金集”——一个精选的高质量数据集,作为生成合成数据的基准[1]。避免将模型过度调整至整个数据集。相反,引入随机性和噪声以捕获边缘情况,而不是简单地复制常见模式[21]。在训练过程中融入差分隐私(DP),以满足GDPR和HIPAA合规标准,同时提供数学上的去标识化保证[1]。
“合成数据不仅仅是替代方案,而是可扩展AI开发的核心组成部分。” – Nascenia[20]
随着生产数据的演变,对生成器进行版本管理并监控漂移。使用诸如Kubeflow或Airflow之类的MLOps平台,通过并行评估不同模型来自动选择最佳合成器[1]。标记元数据,确保兼容性,并将验证后的数据保存为CSV或JSON等格式,以便无缝集成到现有的机器学习流水线中。
结论:利用合成流水线解决AI的数据质量问题
合成数据流水线已成为推进AI发展的基石。到2028年,预计80%的AI训练数据将是合成的,相较于2021年的仅5%有显著增长[25]。这一转变解决了AI面临的一些最大障碍:数据可用性有限、隐私问题、偏差以及安全处理罕见边缘情况的困难。结果如何?带来了重大的运营和成本节约优势。
采用合成流水线的组织可以将成本削减高达99%,同时将模型部署速度提高10倍[1]。例如,手动标记一个单一的边缘情况可能花费€47,000,但合成数据生成将其降至仅€470[1]。一个真实世界的例子来自GoDaddy,该公司在2026年1月报告称,测试数据创建时间减少了90%,并完全消除了测试环境中对生产数据的需求[26]。
合成数据不仅缓解了数据稀缺问题,而且在性能上往往优于真实数据。
- Kalyan Veeramachaneni,麻省理工学院首席研究科学家[25]
这些优势正在各个行业中得到体现。在医疗保健领域,合成数据流程使得罕见病研究成为可能,同时确保符合HIPAA等法规要求。在金融领域,机构可以利用数百万笔合成交易来测试欺诈检测系统。与此同时,自动驾驶汽车公司可以模拟数十亿英里的行驶里程,涵盖在现实世界中无法复制的各种条件[25]。
常见问题
合成数据流程如何在遵守法规的同时保护隐私?
合成数据流程通过采用先进技术对数据进行匿名化处理并保护敏感信息,在维持隐私合规性方面发挥着至关重要的作用。这些流程生成的合成数据与原始数据集脱钩,从而有助于最大程度降低重新识别或隐私泄露的风险。
一个突出的方法是差分隐私,这是一种数学框架,用于限制合成数据可能泄露的关于原始数据集的信息量。其他技术,如隐私掩蔽和精心设计的合成规则,确保生成的数据与真实数据保持区别。这些措施旨在符合GDPR和HIPAA等隐私法律,使组织能够在法律和道德边界内利用高质量数据进行AI训练。
哪些行业从合成数据流程中受益最大?
合成数据流程正在重塑那些面临数据可用性有限、隐私限制或对多样化数据集需求等问题的行业。以医疗保健和生物医学研究为例,这些领域依赖合成数据来保护患者隐私,同时推进AI模型训练和研究工作。
在制造业中,合成数据发挥着不同但同样重要的作用。它有助于简化运营、增强分析能力,并降低与数据收集和标注相关的成本。
此外,像金融、电信和公共服务还可以利用合成数据。它能够实现安全的数据共享,帮助减少偏见,并确保遵守隐私法律。这些流水线是变革性的,使组织能够加速AI开发,提高模型精度,并从敏感或稀缺数据集中提取有价值的见解——同时满足严格的隐私要求。
合成数据流水线如何提升AI模型的性能?
合成数据流水线通过解决数据可用性有限和偏见等问题,在提升AI模型性能方面发挥关键作用。这些流水线创建精心设计、具有代表性的数据集,有助于提高模型的精度、一致性和适应性。
通过模拟各种场景,这些系统能够加快训练和测试过程,减少对昂贵或难以获取的真实世界数据的依赖。这种方法确保AI模型更好地应对现实世界的复杂性,从而产生更可靠的预测和结果。